 It looks like you prefer English. Would you like to view this page in English?
O que é Spec-Driven Development, o que é o OpenSpec, o que o meu schema casadei muda, e o ambiente inteiro montado do zero: Node, CLI do OpenSpec, schema e Claude Code no VS Code.
Este é o primeiro post de uma série para ensinar Spec-Driven Development (SDD) com o OpenSpec, do zero, construindo um projeto de verdade: o SkyLedger BR, uma plataforma em Java e Spring Boot que usa os dados abertos da ANAC para estudar atrasos de voos. Ao longo da série a gente vai passar várias vezes pelo ciclo completo do OpenSpec (explore, propose, apply e archive), sempre com o Claude Code como agente.
Os posts da série:
- SDD com OpenSpec, parte 1: OpenSpec, schema casadei e Claude Code (você está aqui)
- SDD com OpenSpec, parte 2: SkyLedger BR e a infraestrutura local
- SDD com OpenSpec, parte 3: o esqueleto Spring Boot do SkyLedger
- SDD com OpenSpec, parte 4: ingestão dos dados abertos da ANAC no SkyLedger
- SDD com OpenSpec, parte 5: a API de consulta de voos do SkyLedger
Este primeiro post tem duas metades. Na primeira, a parte conceitual: qual problema o SDD resolve, como o OpenSpec organiza o trabalho e o que o openspec-casadei, o schema que eu mantenho, acrescenta ao OpenSpec padrão. Na segunda, mão na massa: instalar tudo, criar o projeto, ativar o schema e configurar o Claude Code, terminando com o Claude Code pronto para a primeira conversa sobre o projeto.
Eu gravei cada passo. Os vídeos estão acelerados nas esperas (digitação longa, telas paradas), então o tempo que você vê não é o tempo real.
O problema: o agente começa a codar cedo demais
Você pede uma funcionalidade para um agente de código e ele começa a escrever código na hora. No caminho, ele infere os requisitos sozinho, e essas suposições nunca ficam escritas em lugar nenhum. A revisão só acontece no diff, que é o lugar mais caro para descobrir que uma premissa estava errada, porque o código já existe. O resultado clássico é um código que compila, passa nos testes e resolve um problema sutilmente diferente do que você pediu.
A frase que resume isso para mim: os erros caros são decididos antes da primeira linha de código, mas só ficam visíveis depois dela.
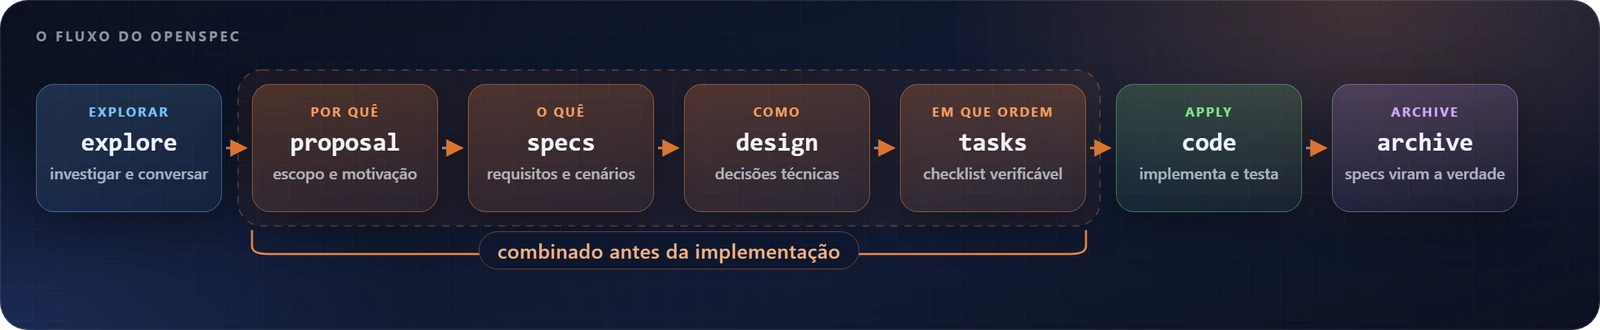
Spec-Driven Development é a resposta a esse problema. Em vez de ir direto da ideia para o código, a gente coloca no meio uma especificação escrita e combinada: o porquê, o que o sistema deve fazer, como vai ser construído e em que ordem. Tudo isso é revisado por uma pessoa antes de o agente implementar qualquer coisa.
O que é o OpenSpec
O OpenSpec é uma ferramenta open source que transforma essa ideia num fluxo de trabalho concreto. A definição que eu uso: um fluxo que coloca uma especificação combinada e escrita entre a ideia e o código.
Quatro termos aparecem o tempo todo, e vale guardar:
| Termo | O que é |
|---|---|
| Change | Uma unidade de trabalho em andamento: uma pasta com proposal, specs, design e tasks |
| Capability | Uma fatia nomeada de comportamento, como user-auth. Vira uma pasta em specs/ |
| Spec | O contrato durável de uma capability: requisitos e cenários |
| Delta | O que uma change adiciona, modifica, remove ou renomeia em relação ao que existe hoje |
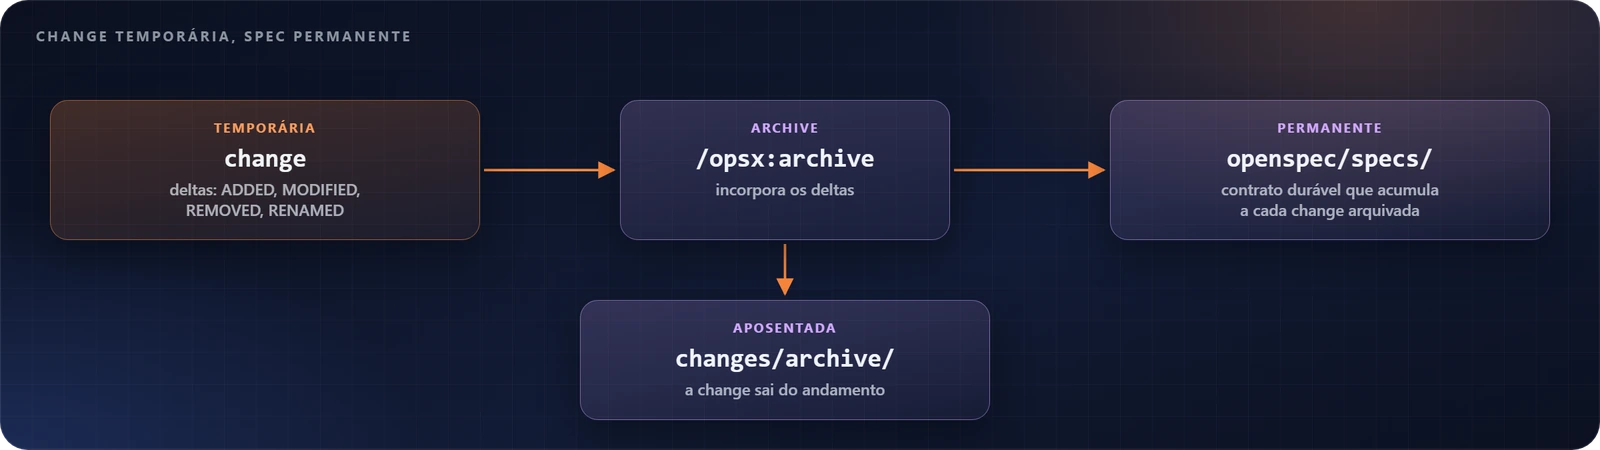
A distinção mais importante: a change é temporária e é arquivada; a spec é permanente e acumula. É isso que impede a documentação de ficar desatualizada, porque ela vira subproduto do próprio trabalho.
Delta-first: por que funciona em sistema legado
Uma change nunca descreve o sistema inteiro, só o que se move. Os cabeçalhos de delta são literalmente estes:
## ADDED Requirements      # comportamento que não existia
## MODIFIED Requirements   # comportamento alterado (conteúdo completo atualizado)
## REMOVED Requirements    # aposentado (precisa de Reason e Migration)
## RENAMED Requirements    # só troca de nome (FROM:/TO:)
Isso desarma a objeção mais comum (“meu sistema tem 80 mil linhas e zero documentação”): a pasta specs/ começa vazia e só é preenchida onde as mudanças encostam. Uma pasta specs/ vazia num repositório legado é o estado inicial correto, não dívida técnica. O SkyLedger BR é um projeto novo, mas o fluxo é exatamente o mesmo.
O que o openspec init cria
seu-projeto/
|-- openspec/
|   |-- config.yaml            # escolha do schema + contexto e regras do projeto
|   |-- specs/                 # specs duráveis das capabilities (cresce com o tempo)
|   |-- changes/               # trabalho em andamento
|   |   |-- add-dark-mode/     #   proposal.md, specs/, design.md, tasks.md
|   |   `-- archive/           #   changes concluídas vão para cá
|   `-- schemas/               # schemas customizados do projeto (opcional)
`-- .claude/                   # slash commands e skills para a ferramenta de IA
Tudo é texto puro, versionado junto com o código, e é revisado num pull request como qualquer outro arquivo.
Os quatro artefatos
Cada change tem até quatro artefatos, e cada um responde a uma pergunta:
| Artefato | Pergunta | Observação |
|---|---|---|
proposal.md |
Por que e o que muda? | Curto. O Why tem uma ou duas frases |
specs/<capability>/spec.md |
O que o sistema deve fazer? | O contrato. Um por capability |
design.md |
Como vai ser construído? | Só quando a mudança justifica |
tasks.md |
Em que ordem, verificado como? | Lido pela máquina: o apply faz parse dos checkboxes |
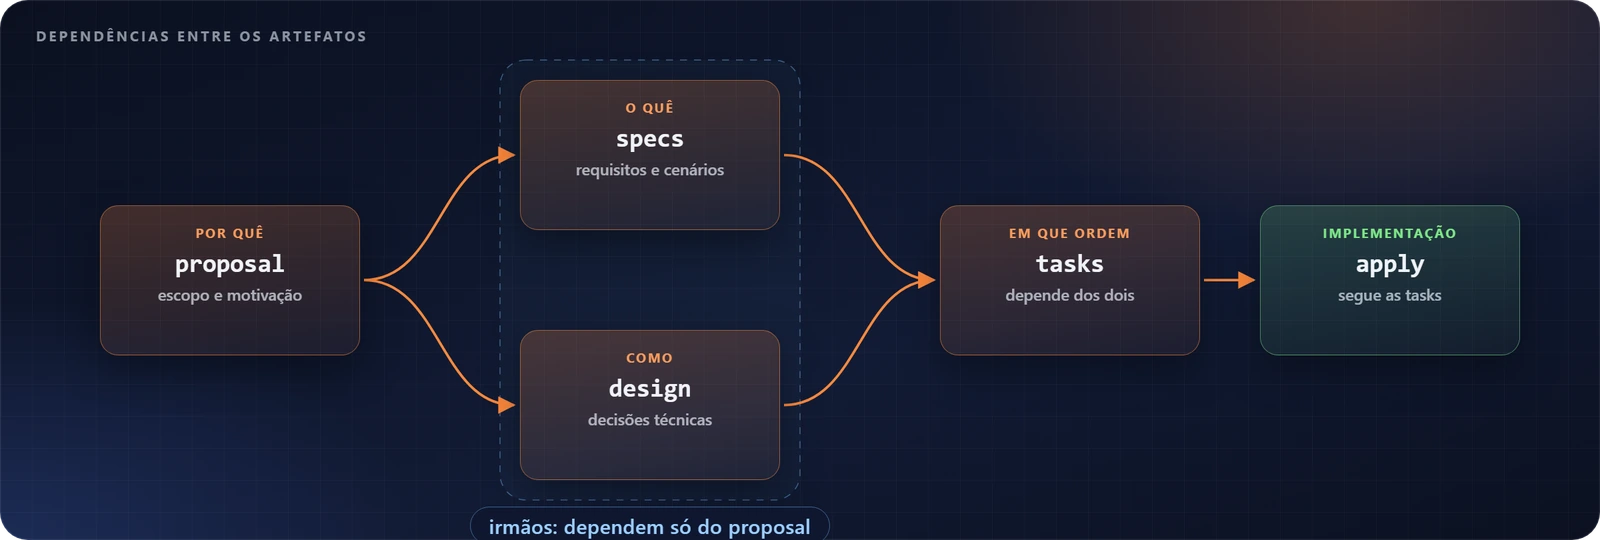
As dependências entre eles são declaradas no schema: specs e design dependem só do proposal (são irmãos), e tasks depende dos dois.
Cada artefato tem um template (o esqueleto escrito no disco) e uma instruction (o texto que o agente lê enquanto preenche). Os dois moram no schema, e é isso que se customiza. Guarde essa ideia, porque é ela que explica o schema casadei mais adiante.
Algumas regras do spec.md pegam muita gente de surpresa, e conhecer antes poupa horas de depuração:
- O cenário usa
#### Scenario:com exatamente quatro cerquilhas. Com três, ou com um bullet, ele falha em silêncio: o cenário simplesmente não existe para o parser. - O corpo do requisito precisa ter
SHALLouMUST. A checagem lê o corpo, não o título. É aviso no modo normal e erro fatal comopenspec validate --strict. - Todo requisito precisa de pelo menos um cenário.
- A spec diz o que o sistema faz, nunca como. Se a implementação pode mudar sem mudar o comportamento visível, aquilo não pertence à spec.
O ciclo de vida de uma change
| Etapa | O que acontece | Comando |
|---|---|---|
| Explore | Pensar junto com o agente, contra o código real, antes de se comprometer | /opsx:explore |
| Propose | Criar a change e escrever os artefatos | /opsx:propose |
| Validate | Checagem estrutural dos deltas e requisitos | openspec validate |
| Apply | Executar a lista de tarefas, marcando os checkboxes | /opsx:apply |
| Archive | Incorporar os deltas em specs/ e aposentar a change |
/opsx:archive |
O archive é o passo que a maioria pula, e é justamente ele que torna a spec durável. Sem archive, as changes se acumulam e nada é consolidado.
E o explore é o passo que eu mais recomendo e que quase ninguém usa. Assistentes de IA são afoitos: peça algo vago e eles constroem alguma coisa com toda a confiança. O explore é uma conversa sem compromisso, em que você e o agente descobrem qual é o movimento certo antes de qualquer artefato existir. Ele lê e pesquisa o código, compara opções com seus tradeoffs, desenha diagramas e transforma uma ideia vaga num escopo que dá para construir. E, igualmente importante, ele não escreve código, não mexe em schema e não começa uma change sozinho. A regra prática: quanto mais vaga a tarefa, mais o explore se paga. Se você já sabe exatamente o que quer e como, vá direto para o propose. No post 2 você vai ver o explore em ação sobre o SkyLedger BR inteiro.
CLI e slash commands: duas coisas diferentes
Essa é uma confusão comum. Existe o CLI, que você roda no terminal:
openspec init --tools claude     # prepara o projeto (novo OU legado)
openspec list --specs            # o que o projeto JÁ cobre
openspec list                    # o que está em andamento agora
openspec show "user-auth" --type spec       # lê uma capability
openspec validate --all          # checagem estrutural
openspec validate <change> --strict         # avisos viram falhas
openspec archive <change>        # incorpora os deltas em specs/ e aposenta a change
E existem os slash commands, que você digita no chat do agente: /opsx:explore, /opsx:propose, /opsx:apply, /opsx:archive, além de /opsx:update (revisar uma change em andamento depois de feedback) e /opsx:sync (reconciliar specs com a realidade quando o código mudou fora do fluxo). Existem mais seis workflows desligados por padrão (new, continue, ff, bulk-archive, verify e onboard), que se ativam com openspec config profile.
Os slash commands são instruções para o agente. Quem de fato lê e escreve a estrutura em disco, valida e decide qual schema está ativo é o CLI. Por isso ele é instalado primeiro. E como é uma ferramenta de linha de comando comum, o mesmo openspec validate --strict que você roda na sua máquina pode rodar num pipeline de CI.
O schema casadei: o que muda em relação ao padrão
O OpenSpec é deliberadamente neutro sobre prática de engenharia, porque precisa servir a qualquer time. Isso não é defeito, é decisão de projeto. Mas eu queria que as minhas regras estivessem dentro do fluxo, em vez de depender de alguém lembrar delas na revisão. Daí nasceu o openspec-casadei.
A decisão de arquitetura que define o resto: é um fork só do schema, não do CLI. Você instala o pacote do npm normalmente, e ele resolve o meu schema pelas camadas de override que o próprio OpenSpec documenta. Sem build, sem pacote interno, sem manter TypeScript. O repositório guarda o schemas/spec-driven/ original intacto, de propósito, como grupo de controle: é contra ele que as minhas mudanças são medidas.
git diff --no-index schemas/spec-driven schemas/casadei
No momento em que escrevo, o README do fork registra +406 linhas e −17, em 5 arquivos: quase tudo acréscimo. O grafo de artefatos é o mesmo do padrão (proposal → specs e design → tasks); nenhum artefato foi adicionado, removido ou reordenado. É uma mudança de conteúdo, não de comportamento.
As principais diferenças
| Área | OpenSpec padrão | schema casadei |
|---|---|---|
| Formato do cenário | **WHEN** / **THEN** |
Linha de ator **AS A** obrigatória |
| Cobertura de cenários | Caminho feliz basta | Cenário de falha ou de borda esperado |
| Breaking changes | Marcar com **BREAKING** |
Também precisa dizer o caminho de depreciação |
| Dependências | Sem posição | Nomeadas no Impact e aprovadas pelo usuário |
design.md |
Context, Goals, Decisions, Risks | Acrescenta Migration Plan, Security & Observability, Open Questions |
| Migrações de banco | Sem posição | Expand-and-contract, com down testado |
| Testes | Cada grupo de tarefas traz seus testes e docs | Também: teste obrigatório por funcionalidade ou correção, mapeado para o cenário BDD, e limite de cobertura nos Quality Gates |
/docs/ |
Sem posição | Atualizado no mesmo commit, em PT-BR |
| Git e commits | Sem posição | Conventional Commits, nome de branch, nada direto na main |
| Autoria | Sem posição | Só o autor humano, sem trailer de coautoria de IA |
| Docblocks | Sem posição | Obrigatórios em todo símbolo exportado |
| Quality gates | Sem posição | Build, lint, análise estática e tipos antes da revisão |
Reparem que quase toda linha da coluna do meio diz “sem posição”. O fork existe exatamente para tomar posição.
Cenários ganham ator e caso de falha
É a diferença que mais aparece no dia a dia. No padrão, um caminho feliz satisfaz o validador. No casadei, todo cenário nomeia quem age, e cada requisito cobre pelo menos a falha que um chamador consegue atingir:
#### Scenario: Successful export
- **AS A** signed-in account holder
- **WHEN** I click the Export button
- **THEN** the system downloads a CSV file with all my data

#### Scenario: Export requested while one is already running
- **AS A** signed-in account holder
- **WHEN** a previous export is still running
- **THEN** the system SHALL return the in-flight export, not start a second
O motivo: um cenário sem ator tende a escorregar para descrever implementação (“WHEN the system processes the queue”). E um detalhe técnico que dá segurança: o OpenSpec não faz parse de WHEN nem de THEN, só conta as quatro cerquilhas. Por isso acrescentar o AS A não quebra nada no validador.
Specs carregam resiliência, LGPD e observabilidade
No casadei, idempotência, limite de retries e DLQ são nível de contrato, então vão na spec e não enterrados no design. “Ele tenta de novo” não é contrato; “no máximo 5 tentativas, depois export-dlq” é. O mesmo vale para LGPD: a janela de retenção é explícita (“retido indefinidamente” não é política de retenção), nada de dado pessoal (CPF, RG, e-mail, telefone, tokens) em log, métrica ou telemetria, e correlation ID e propagação do OpenTelemetry onde um consumidor depende disso.
BREAKING precisa de saída
No padrão, marcar **BREAKING** é o requisito inteiro. No casadei, a entrada precisa dizer o que continua funcionando, por quanto tempo e para onde o consumidor migra. Um **BREAKING** sem caminho de depreciação é tratado como incompleto.
Design e tasks
O design.md ganha três seções condicionais: Migration Plan quando a mudança altera o banco (expand-and-contract em passos separados, e uma migration de volta que funciona), Security & Observability quando há segredo, dado pessoal ou tracing (o segredo é nomeado, com o lugar onde vive em cada ambiente, nunca pelo valor) e Open Questions quando algo é genuinamente adiável. Uma feature flag sem critério de remoção é dívida.
No tasks.md, cada grupo entrega os próprios testes e a própria documentação antes que o próximo grupo construa em cima. Não existe um grupo “Tests” no fim, porque grupo de teste no fim é grupo de teste que não acontece. O último grupo, Quality Gates, é só verificação da branch inteira: build, lint, tipos, cobertura.
Como o agente escreve o código
Durante o /opsx:apply, valem regras que o padrão não tem: seguir as convenções do projeto e não os hábitos do agente; nada de abstração prematura (uma abstração precisa nomear o segundo caso de uso que a justifica); nada de dependência nova sem perguntar; diff mínimo, sem reformatar de passagem; docblocks nos símbolos exportados; e comentário só quando explica o porquê. Ele também descobre como o projeto rastreia trabalho (JIRA ou GitHub Issues), perguntando em vez de inventar um ID de ticket.
Onde uma regra mora decide quando ela vale
Essa foi uma lição que eu aprendi errando. Uma instrução só vale enquanto está no contexto do agente. A instrução de apply do schema só entra em contexto durante um /opsx:apply. Se você simplesmente pede “faz o commit aí”, fora do fluxo, aquela instrução nunca foi carregada. O agente não desobedeceu: ele nunca viu a regra. Foi exatamente o que aconteceu comigo com a regra de não colocar coautoria de IA nos commits.
Por isso a regra de autoria mora em mais de um lugar:
| Onde | Cobre | Instalado por |
|---|---|---|
apply.instruction do schema |
Qualquer /opsx:apply num projeto com o schema |
o próprio schema |
~/.claude/CLAUDE.md |
Toda sessão na sua máquina, em qualquer projeto | install --user |
<projeto>/CLAUDE.md |
Toda sessão naquele repositório | install --project --claude |
O instalador ainda tem a opção --secrets medium|high, que coloca no projeto as ferramentas que forçam as regras de segredo: bloco de regras no .gitignore, hook de pre-commit do gitleaks e um workflow de GitHub Actions que varre o histórico; no nível high, também um openspec/secrets-policy.md. Eu não usei essa opção no SkyLedger BR, mas vale conhecer.
E o princípio que vale para qualquer customização: customize no menor nível que resolve. O config.yaml para um repositório, um schema para o seu jeito de trabalhar, um repositório de schema para compartilhar. No SkyLedger BR a gente vai usar os dois primeiros: o schema casadei para o que vale sempre, e o config.yaml para o que é verdade só sobre este projeto.
Mão na massa
O que vamos montar nesta segunda metade:
- Node.js e o CLI do OpenSpec, instalados globalmente pelo npm.
- O repositório openspec-casadei, clonado uma vez, num lugar permanente. Ele é a fonte do schema, não o projeto.
- O projeto
skyledger-br, comgit init,openspec inite o schema casadei instalado dentro dele. - O Claude Code no VS Code, instalado, logado e em modo Manual, pronto para a primeira conversa sobre o projeto.
Eu usei o VS Code com um terminal bash (Linux). Os comandos de macOS são os mesmos; para Windows nativo, o README do schema traz os equivalentes em PowerShell, e eu cito alguns abaixo.
Passo 1: conferir o Node
O CLI do OpenSpec é distribuído pelo npm e exige Node.js 20.19.0 ou mais novo. Repare que o Node aqui é dependência de ferramenta, não do produto: o SkyLedger BR vai ser Java com Spring Boot, e o Node só existe na máquina por causa do CLI.
node --version
git --version
Na gravação, o VS Code abre na pasta de trabalho, ainda vazia. O painel de chat que vem aberto à direita (“Build with Agent”) é o assistente do próprio VS Code, não o Claude Code; eu fecho para não confundir. O node --version respondeu v24.21.0, com folga.
⏱ Tempo real: 25 s (vídeo acelerado).
Se o Node estiver faltando ou for velho demais, o README do schema sugere:
# macOS
brew install node

# Linux (Debian/Ubuntu): os pacotes da distro costumam ser velhos, use o nvm
curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.40.1/install.sh | bash
nvm install --lts
# Windows
winget install OpenJS.NodeJS.LTS
Por que conferir isso antes? Porque daqui a pouco o Claude Code vai rodar comandos no mesmo terminal que eu uso. Se o Node estiver numa versão antiga, o erro aparece no meio de uma tarefa, muitas vezes de um jeito confuso. Conferir antes custa dez segundos.
Passo 2: instalar o CLI do OpenSpec
npm install -g @fission-ai/openspec@latest
openspec --version
O -g é instalação global: o comando openspec passa a funcionar em qualquer pasta. Na gravação, a saída foi added 70 packages in 8s, seguida de um aviso do próprio npm sobre uma versão nova dele (de 11.19.0 para 12.1.0). Esse aviso é do npm, não do OpenSpec, e dá para ignorar. O openspec --version respondeu 1.13.2, a versão usada em toda a série. Se você instalar hoje, provavelmente vai ver uma versão mais nova.
⏱ Tempo real: 22 s (vídeo acelerado).
Se aparecer openspec: command not found, a pasta de binários globais do npm não está no PATH. O npm prefix -g mostra onde o pacote foi instalado, e a pasta bin dali precisa entrar no PATH.
Passo 3: clonar o openspec-casadei
O schema mora num repositório público, que você clona uma vez, num lugar permanente. Você volta nele para instalar o schema em projetos novos e para trazer atualizações. Os comandos do README:
# macOS / Linux
mkdir -p ~/workspace && cd ~/workspace
git clone git@github.com:vcasadei/openspec-casadei.git
cd openspec-casadei
# Windows (PowerShell)
mkdir $env:USERPROFILE\workspace -Force
cd $env:USERPROFILE\workspace
git clone git@github.com:vcasadei/openspec-casadei.git
cd openspec-casadei
O clone acima usa SSH. Como o repositório é público, se você não tem chave SSH configurada no GitHub, o clone por HTTPS funciona igual: git clone https://github.com/vcasadei/openspec-casadei.git.
Dentro dele, as pastas que importam são schemas/, onde moram o casadei e o spec-driven original, e tools/, onde fica o instalador que vamos usar daqui a pouco. Esse repositório segue o padrão que o próprio OpenSpec documenta para schemas compartilhados: um repositório dedicado e versionado, que os projetos apenas instalam. Uma melhoria no schema é feita uma vez, com histórico de quem mudou o quê e por quê.
Passo 4: criar o projeto e rodar o openspec init
Agora nasce o SkyLedger BR. Eu deixei o projeto ao lado do openspec-casadei, na mesma pasta de trabalho, para ver os dois no mesmo Explorer do VS Code:
cd ~/workspace
mkdir skyledger-br && cd skyledger-br
git init
openspec init
O openspec init interativo mostra a tela “Welcome to OpenSpec”, explica que vai configurar as Agent Skills e os comandos de workflow, e lista as ferramentas de IA suportadas, em três páginas (Codex, Cursor, Gemini CLI, GitHub Copilot e várias outras). Eu marquei o Claude Code. Para pular a pergunta, use openspec init --tools claude, que faz a mesma coisa.
Na gravação há um deslize meu: criei a pasta como skiledger-br, com “i”. Ela aparece assim no Explorer, e eu corrijo o nome mais adiante, antes de instalar o schema.
⏱ Tempo real: 43 s (vídeo acelerado).
Um cuidado: não use --language pt-BR no init. Essa flag faz o OpenSpec escrever os artefatos de spec em português, e o schema casadei mantém as specs em inglês de propósito (a checagem de SHALL/MUST do validador só funciona em inglês), enquanto exige a pasta /docs/ em PT-BR. Essa divisão já está resolvida nas instruções do schema.
Passo 5: ler a saída do init (e o autocompletar)
O resumo do init diz o que ele criou:
Created: Claude Code
6 skills and 6 commands in .claude/
Config: openspec/config.yaml (schema: spec-driven)
Logo abaixo vem a sugestão de começar com /opsx:propose e a nota sobre os seis workflows extras. A linha que importa é a do config.yaml: o OpenSpec sempre nasce com o schema genérico, o spec-driven. Ele funciona, mas não sabe nada das minhas regras: não exige cenário de falha, não fala de LGPD, não amarra testes e documentação a cada grupo de tarefas. É essa linha que vamos trocar.
O próprio init sugere instalar o autocompletar do shell, e eu aceitei:
openspec completion install
exec bash
⏱ Tempo real: 32 s (vídeo acelerado).
A primeira linha da saída parece erro: Unable to read existing completion file, com ENOENT. Não é. Ela só diz que ainda não havia um arquivo de autocompletar anterior, e a linha seguinte confirma: Completion script installed and .bashrc configured successfully. É um bom exemplo de um hábito que vale para a série inteira: ler a saída até o fim antes de concluir que algo quebrou. Isso vale para você e vale para o agente quando ele lê saídas de comando.
Passo 6: instalar o schema casadei no projeto
O passo central. O instalador roda de dentro do openspec-casadei, apontando para o projeto. A ordem importa: rode o openspec init antes, para que exista um config.yaml onde o instalador possa escrever.
cd ~/workspace/openspec-casadei
./tools/install.sh --project ../skyledger-br --claude
# Windows, da raiz do openspec-casadei
.\tools\install.ps1 -Project C:\caminho\para\skyledger-br -Claude
Na gravação, entre começar a digitar o comando e completá-lo, eu renomeio a pasta para skyledger-br, com “y”, para o caminho ficar certo daqui para frente. A saída tem três linhas, e cada uma significa algo:
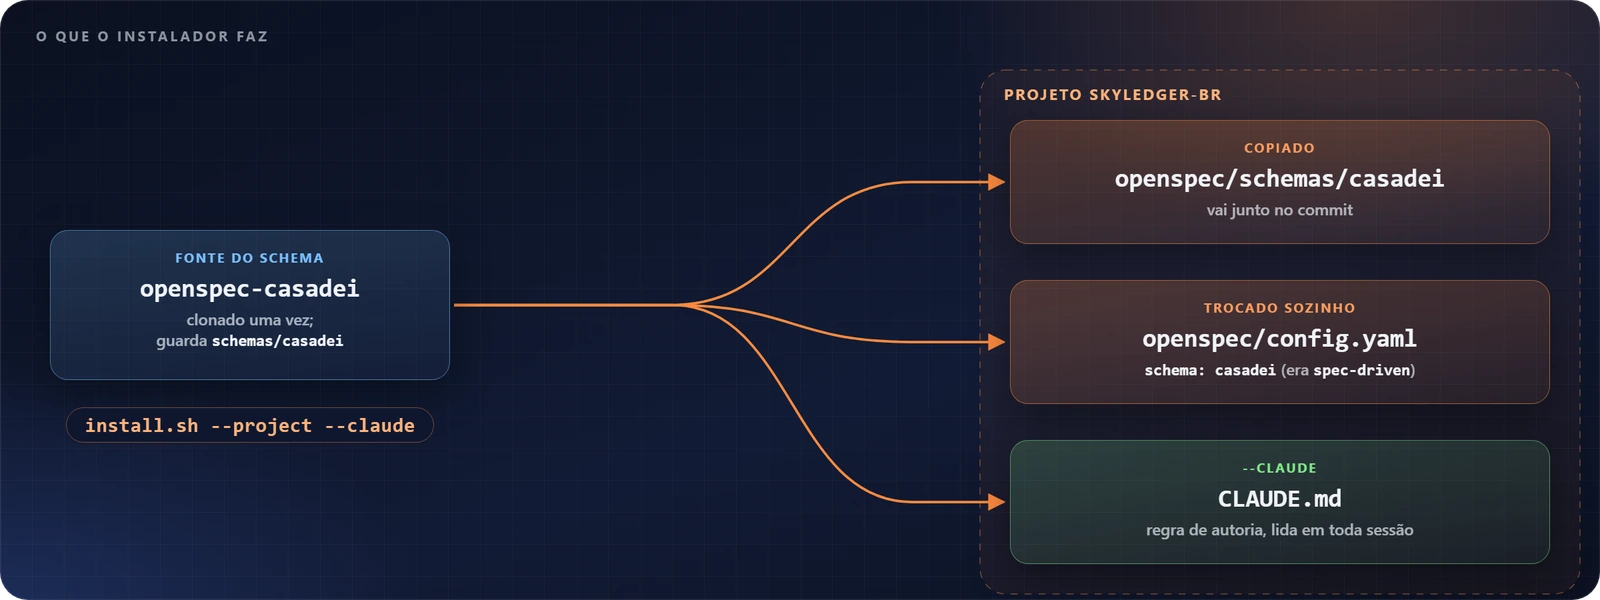
Installed schema 'casadei'  ->  .../skyledger-br/openspec/schemas/casadei
Set 'schema: casadei' in openspec/config.yaml (was 'spec-driven')
Created CLAUDE.md with the authorship rule
- O schema foi copiado para dentro do projeto.
- O
config.yamlfoi trocado sozinho, sem edição manual. - A flag
--claudecriou umCLAUDE.mdcom a regra de autoria dos commits.
E a última linha sugere a verificação: Verify with: openspec schema which casadei.
⏱ Tempo real: 1 min 07 s (vídeo acelerado).
Três decisões estão embutidas nesse comando:
--projectem vez de--user. O--userinstala uma vez por máquina e fica invisível para quem mais trabalha no repositório: se oconfig.yamldizschema: casadeie a pessoa não tem o schema, o CLI dela dá erro. O--projectcopia o schema para dentro do repositório e ele vai junto no commit. Quem clonar o SkyLedger BR depois recebe as mesmas regras, sem configurar nada.--claude. Sem ele, a regra de autoria só vale durante um/opsx:apply. Com oCLAUDE.md, o Claude Code lê a regra em toda sessão naquele repositório.- Nada de edição manual do
config.yaml. O instalador só troca a linhaschema:de primeiro nível, e só quando ela dizspec-driven. Se o projeto já apontar para outro schema, ele não sobrescreve; só avisa. Trocar em silêncio um schema escolhido de propósito seria pior do que pedir para você digitar uma linha.
Um detalhe que o README do schema destaca: o .gitignore do OpenSpec upstream lista CLAUDE.md, e projetos que herdaram essa regra podem ignorar o arquivo sem você perceber. O instalador avisa quando o CLAUDE.md que ele escreveu está ignorado pelo git e mostra a exceção a acrescentar (!CLAUDE.md). No SkyLedger BR o arquivo foi commitado normalmente.
Passo 7: conferir qual schema está ativo
Aqui eu errei de novo, e o erro ensina. Rodei a verificação ainda dentro do openspec-casadei:
$ openspec schema which casadei
Error: Schema 'casadei' not found
Available schemas: spec-driven
Não é bug: o schema foi instalado no projeto, e o CLI resolve o schema a partir da pasta atual. Dentro do projeto, o resultado é o esperado:
cd ../skyledger-br
openspec schema which casadei
cat openspec/config.yaml
openspec schema which --all
Schema: casadei
Source: project
Path: .../skyledger-br/openspec/schemas/casadei
Source: project é exatamente o que a gente queria ver. O cat mostra que a primeira linha do config.yaml agora é schema: casadei, e o resto são comentários de exemplo (“Project context (optional)”, “Per-artifact rules (optional)”). E o schema which --all mostra os dois lado a lado: casadei em Project schemas e spec-driven em Package schemas. Repare também no aviso de que os comandos schema ainda são experimentais.
⏱ Tempo real: 54 s (vídeo acelerado).
Dois pontos para levar daqui:
- O instalador copia arquivos, não cria atalho. Se o schema melhorar depois, cada projeto precisa reinstalar para pegar a mudança. É uma escolha consciente: o schema do projeto fica estável e versionado junto com o código, e atualizar o processo é um ato explícito, que aparece no histórico.
- O OpenSpec sempre trabalha relativo à pasta onde você está. Isso vale também para o Claude quando ele rodar comandos.
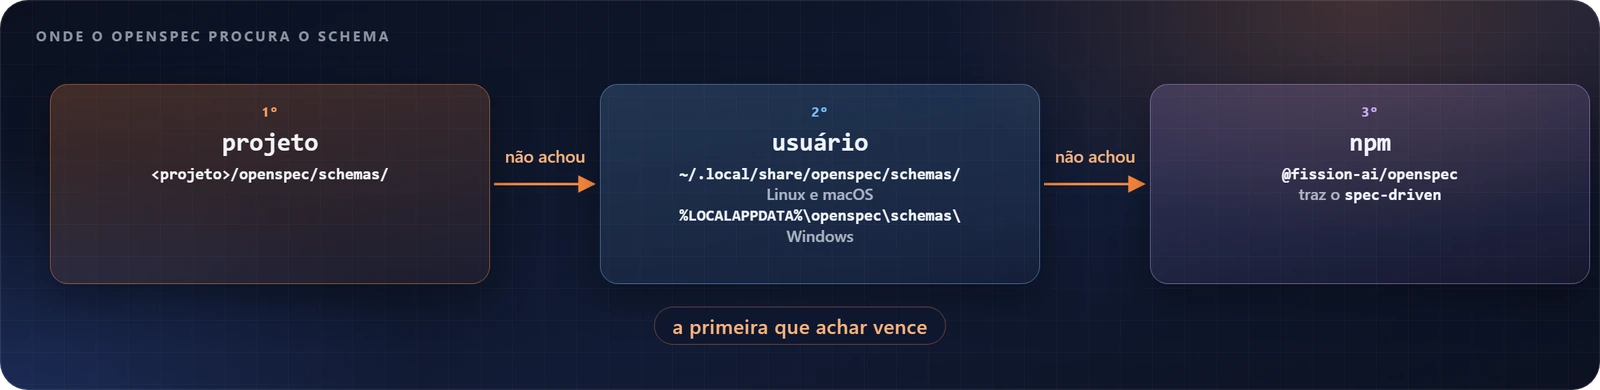
A ordem de resolução do schema explica o Source: project: o OpenSpec procura primeiro em <projeto>/openspec/schemas/, depois na pasta de dados do usuário (~/.local/share/openspec/schemas/ no Linux e no macOS, %LOCALAPPDATA%\openspec\schemas\ no Windows) e por último no pacote do npm. A primeira que achar vence.
Onde estamos
Antes de abrir o Claude, vale um checklist do que já está pronto:
- CLI do OpenSpec 1.13.2 instalado globalmente pelo npm.
- openspec-casadei clonado: é a fonte do schema, não o projeto, e você não mexe nele.
- skyledger-br criado, com
git initeopenspec initcom o Claude Code como ferramenta. - Pasta
.claude/com 6 skills e 6 comandos/opsx. - Schema copiado para
openspec/schemas/casadei, versionado com o código. config.yamlcomschema: casadei.CLAUDE.mdcom a regra de autoria, lido pelo Claude em toda sessão.
O que falta é dizer ao OpenSpec o que é verdade sobre este projeto: a stack, as regras de domínio e de onde vêm os dados. Isso já é específico do SkyLedger BR, então fica para o post 2, onde a gente escreve o config.yaml junto com o Claude.
Claude Code no VS Code
Instalando a extensão
No painel de Extensões do VS Code, busque por Claude Code e instale a Claude Code for VS Code, publicada pela Anthropic, com o selo de publisher verificado. O selo é o que garante que não é uma extensão de terceiros com nome parecido. Eu aproveitei e instalei também o Container Tools, da Microsoft, que o próprio VS Code recomendou e que vai ser útil quando a gente chegar na infraestrutura com Docker, no post 2.
⏱ Tempo real: 48 s (vídeo acelerado).
Com a extensão instalada, aparece o ícone do Claude na barra lateral. A extensão roda no mesmo ambiente do editor: quando o Claude executar um comando, ele usa o mesmo terminal, o mesmo openspec 1.13.2 e o mesmo git que a gente acabou de configurar. O que eu vejo no terminal é o que o agente vê. Se preferir, dá para rodar o comando claude direto no terminal integrado; funciona do mesmo jeito. Eu uso o painel porque fica mais fácil acompanhar o que ele está fazendo, passo a passo.
Login e primeira sessão
Na primeira vez, o painel pergunta “How do you want to log in?”, com três opções: Claude.ai Subscription (planos Pro, Team ou Enterprise), Anthropic Console (cobrança por uso de API) e Bedrock, Foundry ou Vertex, para quem usa o Claude por um provedor de nuvem. Eu uso a assinatura. Depois do login aparece o painel de conta, com o uso da janela de cinco horas e o Session Manager; clico em New session.
⏱ Tempo real: 54 s (vídeo acelerado).
A sessão abre com o modelo Opus 5.5, esforço Medium, e um aviso: “Auto mode is enabled”. No modo Auto, o Claude avalia cada chamada de ferramenta, executa as que considera de menor risco e bloqueia o resto. O menu de modos tem quatro opções: Manual (pede aprovação antes de cada edição), Edit automatically, Plan (explora e apresenta um plano antes de editar) e Auto. Dá para alternar com Shift+Tab.
Trocando para o modo Manual
Eu levei o painel do Claude para a área principal do editor, para ter espaço de leitura, e troquei para Manual: “Claude will ask for approval before making each edit”.
⏱ Tempo real: 24 s (vídeo acelerado).
Fiz isso de propósito. Para um primeiro contato, quero que cada leitura, busca ou escrita do agente fique visível e, quando for o caso, passe por mim. Não é desconfiança: é o mesmo princípio do SDD aplicado num nível menor. O OpenSpec garante que nenhuma decisão relevante aconteça sem revisão humana, no nível dos artefatos; o modo de permissão faz o mesmo no nível das ações individuais. São camadas complementares. Conforme você ganha confiança no fluxo, faz sentido relaxar. O importante é que seja uma escolha consciente, e não o padrão de fábrica.
Com a extensão instalada, o login feito e o modo Manual ativo, o ambiente está pronto. A primeira conversa com o Claude já é sobre o SkyLedger BR, e por isso ela abre o post 2.
Não tem Claude Code? Uma alternativa gratuita
Nada aqui depende do Claude Code especificamente: o openspec init suporta dezenas de ferramentas, e o schema é o mesmo. Se você quer praticar sem pagar nada, eu escrevi um passo a passo com o mesmo OpenSpec e o mesmo schema casadei rodando no opencode com modelos gratuitos: Spec-Driven Development com opencode e modelos gratuitos do InkStone. Os comandos mudam de /opsx:propose para /opsx-propose, mas o fluxo é o mesmo.
Problemas comuns
| Sintoma | Causa e solução |
|---|---|
openspec: command not found |
A pasta bin global do npm não está no PATH. Confira com npm prefix -g. |
Schema 'casadei' not found |
Pasta errada (o CLI resolve o schema a partir da pasta atual) ou escopo errado. Entre no projeto e rode openspec schema which --all; se não aparecer, reinstale. |
| O instalador avisa que o schema não foi selecionado | Não havia config.yaml. Rode openspec init e depois o instalador de novo. |
| O PowerShell não roda o script | Política de execução: powershell -ExecutionPolicy Bypass -File tools\install.ps1 -User. |
| Editei o schema e nada mudou no projeto | O instalador copia, não cria link. Reinstale. |
No deltas found no validate |
Cerquilhas do cenário (são quatro) ou cabeçalhos de delta errados. |
should contain SHALL |
Falta SHALL/MUST no corpo do requisito. É fatal com --strict. |
O projeto da série: SkyLedger BR
O SkyLedger BR é uma plataforma que usa dados abertos da ANAC para calcular o risco de atraso de voos e simular a exposição financeira de um benefício de reembolso por atraso. A ideia por trás: muitos cartões de crédito premium incluem “proteção de viagem”, e quem oferece esse benefício precisa saber, para qualquer rota ou aeroporto, qual a probabilidade histórica de atraso ou cancelamento e quanto dinheiro reservar para isso.
Esse enquadramento junta duas coisas que eu queria exercitar com SDD: rigor financeiro (BigDecimal, rastreabilidade de dados, nada de ponto flutuante em dinheiro) e dados públicos reais. Os dados vêm do portal de dados abertos da ANAC, principalmente o VRA (Voo Regular Ativo), com horários previstos e realizados, atrasos e cancelamentos por voo, e a lista de aeródromos. Para ninguém depender de download na hora, eles ficam num repositório separado, o anac-data, que você clona e já tem os CSVs.
A stack é a que ficou registrada no config.yaml: Java 21, Spring Boot 4.1, Maven, PostgreSQL 16, Redis 8 e SeaweedFS. O código completo está em github.com/vcasadei/skyledger-br, com uma branch para cada fase de cada change (1-propose, 2-apply, 3-archive), para você comparar os artefatos com o que eu mostro e fazer checkout em qualquer ponto. A main é o estado final.
O que os próximos posts constroem, cada um com o seu ciclo completo do OpenSpec:
- Parte 2: infraestrutura local. Começa com um
/opsx:exploresobre o projeto inteiro e segue com a changesetup-local-infra: Postgres, Redis e SeaweedFS com Docker Compose. - Parte 3: esqueleto Spring Boot. A change
bootstrap-project-skeleton: a aplicação que sobe, conecta na infraestrutura e responde ao health check. - Parte 4: ingestão dos dados da ANAC. A change
add-flight-data-ingestion: voos e aeródromos do anac-data no banco. - Parte 5: API de consulta de voos. A change
add-flight-query-api: a API REST documentada com OpenAPI e uma tela de busca.
O ambiente está pronto. No próximo post, a gente começa a conversar com o Claude sobre o SkyLedger BR: escreve o contexto do projeto no config.yaml, explora o projeto inteiro e propõe a primeira change: SDD com OpenSpec, parte 2: SkyLedger BR e a infraestrutura local.
Navegação da série: você está na parte 1 · Próximo: Parte 2: SkyLedger BR e a infraestrutura local →
Referências
- Spec-Driven Development e OpenSpec
- OpenSpec · Documentação · pacote no npm
- openspec-casadei, o meu schema para o OpenSpec · customização de schemas · OpenSpec em projetos existentes
- Claude Code
- Ambiente
- O projeto
- Alternativa gratuita
Se esta série te ajudar a começar com SDD, me conta no LinkedIn (linkedin.com/in/vcasadei) ou confira outros projetos e textos que publico em vcasadei.com.