 It looks like you prefer English. Would you like to view this page in English?
O primeiro ciclo completo do OpenSpec num projeto de verdade: pensar o SkyLedger BR inteiro com o /opsx:explore e depois propor, implementar, arquivar e testar a infraestrutura local com Docker Compose.
Este post faz parte de uma série para ensinar Spec-Driven Development (SDD) com o OpenSpec, do zero, usando um projeto real como fio condutor.
Série “SDD com OpenSpec”
- SDD com OpenSpec, parte 1: OpenSpec, schema casadei e Claude Code
- SDD com OpenSpec, parte 2: SkyLedger BR e a infraestrutura local (você está aqui)
- SDD com OpenSpec, parte 3: o esqueleto Spring Boot do SkyLedger
- SDD com OpenSpec, parte 4: ingestão dos dados abertos da ANAC no SkyLedger
- SDD com OpenSpec, parte 5: a API de consulta de voos do SkyLedger
O que é o SkyLedger BR
Se você chegou direto aqui: o SkyLedger BR é o projeto que eu uso nesta série para praticar SDD de ponta a ponta. É uma plataforma em Java com Spring Boot que usa os dados abertos da ANAC (voos e aeroportos) para calcular risco de atraso e simular quanto custaria, para um banco, um benefício de cartão de crédito do tipo “reembolso por atraso de voo”.
A stack está fixada desde o começo: Java 21, Spring Boot 4.1 com Maven, PostgreSQL 16, Redis 8 e SeaweedFS 4.40 ou superior como armazenamento de objetos compatível com S3. O código é público em github.com/vcasadei/skyledger-br, com uma branch para cada fase de cada change, e os dados ficam num repositório separado, o anac-data.
Pré-requisito: este post parte de um projeto com o OpenSpec instalado, o meu schema openspec-casadei configurado e o Claude Code pronto no VS Code. Tudo isso está no post 1 da série. Se você prefere praticar sem gastar nada, com um agente open source e modelos gratuitos, veja também o meu post sobre o opencode e o InkStone.
O que vamos fazer neste post
Esta é a primeira change do projeto, e de propósito ela não é código de aplicação: é a infraestrutura local que o SkyLedger vai precisar, com PostgreSQL, Redis e SeaweedFS rodando em Docker Compose. Eu escolhi começar por aqui para mostrar uma coisa que considero central: o ciclo do OpenSpec não serve só para código Java. Serve para qualquer coisa que entre no repositório, inclusive configuração. Eu não vou entregar um docker-compose.yml pronto; vou descrever em português o que preciso e deixar o agente propor.
Antes da primeira change, porém, vêm dois passos: contar ao OpenSpec o que é verdade sobre o SkyLedger BR, no config.yaml, e o /opsx:explore, uma conversa sem arquivos para pensar o projeto inteiro.
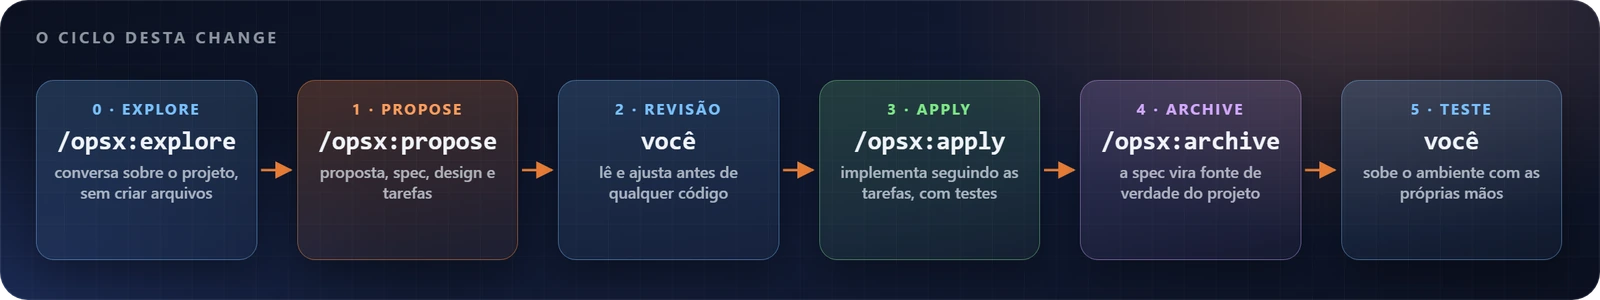
Tudo foi feito no VS Code com a extensão do Claude Code (modelo Opus 5.5, esforço médio). Eu gravei cada etapa; os vídeos estão acelerados nos trechos em que o agente trabalha sozinho, e eu explico no texto o que acontece em cada um.
Primeiro passo: o contexto do projeto no config.yaml
O openspec init e o schema casadei deixaram o projeto com a estrutura do OpenSpec, mas o OpenSpec ainda não sabe nada sobre o SkyLedger BR: a stack, as regras de domínio e de onde vêm os dados. Isso vai no context e nas rules do openspec/config.yaml. O schema traz as regras que valem para qualquer projeto meu; o config.yaml traz as que valem só para este. Essa separação é o que mantém o config.yaml curto e evita que as duas fontes digam coisas diferentes com o tempo.
Escrevendo o contexto do projeto
Em vez de escrever o YAML à mão, eu contei ao Claude o que é verdade sobre o projeto. Repare: não há nenhum /opsx aqui. O /opsx:propose é para mudanças no produto; aqui estou configurando a própria ferramenta, então basta uma mensagem comum. Este é o texto exatamente como eu enviei, com os erros de digitação:
Nosso projeto usa Java 21, Spring Boot 4.1, Maven, Postgresql 16, resis 7 e seaweedFS (pode sugerir atualizações caso veja problemas de segurança ou end of life). Valores monetários são sempre BigDecimal, numca double/float, isso é uma regra, não está no schema padrão. Todo endpoint REST público precisa de documentação OPENAPI. Os dados vem do repositório anac-data, e o caminho para eles deve ser configurável, não hard coded.

Atualize o openspec/config.yaml (schema: casadei) com esse contexto e adicione regras equivalentes para os artefatos proposal, specs e tasks, sem repetir o que já está coberto pelo schema casadei.
⏱ Tempo real: 3 min 02 s (vídeo acelerado).
Algumas escolhas deliberadas nesse prompt:
- Fatos, não YAML. Eu digo o que é verdade e deixo o Claude estruturar o arquivo no formato que o OpenSpec espera (
contexterules). Eu fico responsável só pelo conteúdo, que é o que eu de fato conheço. - “isso é uma regra, não está no schema padrão”. Digo explicitamente o que é específico do projeto.
- “configurável, não hard coded”. O caminho dos dados tem que vir de configuração, para o mesmo código rodar na minha máquina, num pipeline e num servidor.
- “sem repetir o que já está coberto pelo schema casadei”. Eu não listei o que o schema cobre. O Claude teve que ler o schema para descobrir.
- O parêntese sobre segurança e fim de suporte eu acrescentei na hora, e foi ele que mudou o resultado, como você vai ver.
Três regras de domínio bastam aqui: dinheiro exato (BigDecimal, nunca double ou float, que geram erros de arredondamento), contrato de API documentado com OpenAPI e dados externos configuráveis. São justamente as que o schema não tem como saber.
O Claude lê, pesquisa e só depois escreve
Vale prestar atenção na ordem das ações. O primeiro comando dele (ls e cat do openspec/config.yaml) falhou, porque a pasta aberta no VS Code é a pasta de trabalho, e não o projeto. Ele não insistiu no erro: rodou um find, percebeu que existem dois repositórios lado a lado, entrou no skyledger-br e leu o config.yaml, o CLAUDE.md, o schema.yaml e a documentação do openspec-casadei sobre context e rules. Aprendeu o formato antes de escrever.
Aí veio a frase: “Li o schema casadei; vou checar rapidamente o status de suporte das versões da stack antes de escrever o config.” E, como estou no modo Manual, o pedido de permissão: “Allow searching for this query?”, com as opções Yes, Yes, allow WebSearch for this project e No. Eu escolhi Yes em cada uma das três buscas (fim de suporte do Redis 7.2 e 7.4, suporte do Spring Boot 4.1 e CVEs do SeaweedFS em 2026). Liberar uma busca por vez é coerente com o modo Manual: nesta primeira sessão eu quero ver cada ação.
Só então ele escreveu o config.yaml (37 linhas) e pediu permissão para validar o próprio trabalho: um python3 que carrega o YAML e conta as regras, mais um openspec instructions proposal. A saída: ['schema', 'context', 'rules'] e {'proposal': 4, 'specs': 3, 'tasks': 4}. Ele não confiou no que escreveu; conferiu.
⏱ Tempo real: 1 min 51 s (vídeo acelerado).
O resumo: regras, escolhas e alertas
A resposta é longa e vale ser lida com calma. Ela tem três partes.
O que ele escreveu. O YAML é válido e tem context e rules para proposal, specs e tasks. E uma observação honesta: ele não conseguiu ver as regras injetadas pelo openspec instructions, porque o comando exige uma change existente e o projeto ainda não tem nenhuma. O detalhe de que eu mais gostei está nos specs: “o schema proíbe citar frameworks nos specs, então escrevi as regras como contrato, sem mencionar BigDecimal nem ferramentas de OpenAPI”. A regra do BigDecimal virou contrato: escala, moeda, arredondamento e representação decimal exata. É o schema e o contexto se combinando, sem que eu tenha pedido. E ele deixou de fora, de propósito, o que o schema já cobre: aprovação de dependências novas, testes e docs dentro de cada grupo, /docs em PT-BR, segredos, LGPD, idempotência e migrações expand-and-contract.
As escolhas dele. Ele declarou duas decisões como dele, para eu revisar: não deu nome à propriedade do caminho do anac-data (“isso é decisão de vocês”) e supôs que o projeto vai usar o Maven Wrapper, por isso os Quality Gates citam ./mvnw verify. Um agente que declara o que supôs torna a revisão direcionada: eu sei exatamente o que conferir.
Os alertas de versão, com a ressalva “não mexi na stack registrada; são só sugestões”:
| Componente | Alerta |
|---|---|
| SeaweedFS | Ação urgente: vários CVEs críticos em 2026, entre eles path traversal com CVSS 10 e bypass de autenticação. Usar no mínimo a 4.40 |
| Redis 7 | O 7.2 não recebe mais patches. Migrar para Redis 8.x ou Valkey 8; “como envolve licença, a decisão é de vocês” |
| Spring Boot 4.1 | Suporte OSS até 31/07/2027; planejar a 4.2 ou a 4.3 |
| Java 21 e PostgreSQL 16 | Sem ação |
E o fecho: ele não conseguiu verificar algumas fontes de terceiros, e recomendou confirmar as versões corrigidas nos release notes oficiais antes de atualizar.
⏱ Tempo real: 1 min 16 s (vídeo acelerado).
O ajuste: Redis 8 e SeaweedFS 4.40
Decidi aceitar duas sugestões. Para o SeaweedFS, registrar a versão mínima custa quase nada e o risco era alto. Para o Redis, migrar era necessário, e escolhi o Redis 8 para manter o mesmo produto; a questão da licença (o Redis 8 tem três à escolha: RSALv2, SSPLv1 ou AGPLv3) ficou registrada como ponto aberto. A mensagem foi curta, exatamente assim:
atualize a versão do seaweedfs no config. E redis mude para 8
Eu não disse qual versão do SeaweedFS: a recomendação já estava na resposta anterior, e o config.yaml aberto no editor foi anexado à mensagem como contexto. A edição foi cirúrgica: só duas linhas da stack mudaram, com o motivo registrado ali mesmo. E o Claude fez questão de avisar que isso só muda o que os artefatos vão considerar como stack; a atualização de verdade (imagens Docker, compose) ainda precisa ser feita. Mudar texto no config.yaml não atualiza nenhum container, e ele não fingiu que atualizou.
⏱ Tempo real: 1 min 10 s (vídeo acelerado).
O config.yaml final é este, como foi commitado no primeiro commit do repositório (trecho):
schema: casadei

# Project context: shown to the AI when creating every artifact.
context: |
  Stack:
  - Java 21 (LTS), Spring Boot 4.1, build com Maven
  - PostgreSQL 16 (banco relacional principal)
  - Redis 8 (cache)
  - SeaweedFS 4.40 ou superior (armazenamento de objetos/arquivos) - versões
    anteriores têm CVEs críticos (path traversal, SSRF, bypass de IAM)

  Convenções do projeto:
  - Valores monetários são SEMPRE BigDecimal - nunca double, float nem outro
    tipo de ponto flutuante binário, em nenhuma camada (domínio, DTO,
    persistência, testes). No PostgreSQL, colunas monetárias usam NUMERIC com
    precisão e escala explícitas.
  - Todo endpoint REST público tem documentação OpenAPI.
  - Os dados de origem vêm do repositório anac-data. O caminho até ele é
    configuração externa (propriedade Spring sobrescrevível por variável de
    ambiente), nunca um caminho fixo no código, em testes ou em fixtures.

# Per-artifact rules: only what the casadei schema does not already cover.
rules:
  proposal:
    - Quando a mudança envolver valores monetários, liste em Impact cada campo monetário afetado (entrada, saída, persistência) para que specs e tasks tratem precisão e arredondamento.
    - Quando a mudança criar ou alterar endpoints REST públicos, liste-os em Impact (método e caminho) - cada um exige documentação OpenAPI.
    # ... mais duas regras (anac-data, Redis/SeaweedFS)
  specs:
    - Todo requisito sobre valor monetário SHALL declarar escala (casas decimais), moeda e regra de arredondamento, e o contrato SHALL exigir representação decimal exata - valores não trafegam como número de ponto flutuante. Inclua um cenário que exercite o arredondamento.
    # ... mais duas regras (contrato completo de endpoint, cenários de caminho do anac-data)
  tasks:
    # ... três regras (OpenAPI, testes de escala/arredondamento, propriedade do caminho)
    - Quality Gates usam os comandos Maven do projeto (Maven Wrapper `./mvnw` quando existir), por exemplo `./mvnw verify`, em vez de descrições genéricas.
Leia procurando o que não está ali: nada de LGPD, formato BDD, expand-and-contract, coautoria de IA ou /docs. Tudo isso vem do schema. Um config.yaml curto é sinal de que o schema está fazendo o trabalho dele. E a partir de agora, todo proposal, spec e tasks do SkyLedger BR nasce com esse contexto: uma decisão tomada uma vez vale para todas as mudanças seguintes.
No Explorer, o skyledger-br agora tem .claude/, openspec/ (com changes, schemas e specs), config.yaml e CLAUDE.md. Esse estado inicial virou o commit chore: bootstrap OpenSpec workflow with casadei schema.
Parte 0: o explore, pensando o projeto antes da primeira change
Abrindo o projeto certo
O primeiro cuidado é banal, mas define o que o agente enxerga: abrir no VS Code só a pasta skyledger-br, e não uma pasta acima com outros repositórios. O OpenSpec procura a pasta openspec/ na raiz do workspace, e o config.yaml é o contexto fixo do projeto. Tudo o que estiver ali o agente não precisa perguntar; tudo o que não estiver, ele vai ter que perguntar ou supor.
O config.yaml que acabamos de escrever está aberto no editor. No canto do painel do Claude Code, o modo de permissão está em Manual: cada comando e cada arquivo vai pedir a minha aprovação.
⏱ Tempo real: 36 s (vídeo acelerado).
O prompt do explore
O /opsx:explore não cria nenhum arquivo. É uma conversa: eu penso em voz alta com o agente sobre o projeto inteiro, e ele pensa olhando o repositório real, antes de a gente se comprometer com qualquer coisa. Este é o texto exato que eu mandei, com os erros de digitação e tudo:
/opsx:explore Quero começar o projeto Skyledger BR: uma plataforma Java (Spring Boot) que usa dados abertos da ANAC (voos, aeroports) para calcular risco de atraso e simular a exposição financeira de um benefício de cartão de crédito (reembolso por atraso de voo)

Ao longo das próximas semanas pretendo construir, nessa ordem:
1. Infraestrutura local (Postgres, Redis, SeaweedFS) via docker Compose
2. Um esqueleto Spring Boot básico
3. Injestão dos dados de voo da Anac
4. Analytics de pontualidade e tráfego de aeroportos com cahe em Redis
5. Como extensão opcional, cold storage dos arquivos brutos e simulador de risco financeiro

Antes de eu começar a propor mudanças formais, quero pensar em voz alta com você: dado esse plano, existe alguma dependência entre essas partes que eu deveria conhecer antes de começar? Alguma decisão de arquitetura que valha a pena travar logo no início, para não ter que desfazer depois? Me ajude a pensar e planejar.
O prompt tem três partes: o que é o produto, as etapas na ordem em que eu pretendo construir e o pedido. Repare no que não está ali: eu não peço arquivo, código nem proposta, e não peço uma lista de tecnologias (isso o config.yaml já fixou). Peço relações entre as etapas e decisões com custo alto de reversão. Também descrevo a minha ordem sem dizer que ela está certa, o que dá espaço para o agente discordar. E os erros (“aeroports”, “Injestão”, “cahe”) não atrapalham em nada: no explore, o conteúdo importa mais que a forma.
⏱ Tempo real: 4 min 04 s (vídeo acelerado).
Antes de opinar, ele olha o repositório
A primeira frase da resposta é “Vou dar uma olhada no que já existe no repositório antes de pensarmos juntos.” E ele roda só comandos de leitura:
openspec list --json; echo ---; openspec list --specs --json; echo ---; ls -la openspec; cat openspec/config.yaml
Ou seja: quais changes existem, quais specs existem e qual é o contexto fixo do projeto. Num segundo comando ele procura o repositório anac-data, que ninguém mandou procurar. Ele foi atrás porque o config.yaml diz que os dados vêm de lá. Como o repositório não estava acessível naquele momento, ele disse isso abertamente em vez de inventar o conteúdo dos arquivos. A lição prática: se você quer que o explore pense contra os dados reais, deixe os dados acessíveis no workspace.
⏱ Tempo real: 52 s (vídeo acelerado).
As dependências reais não seguem a ordem da lista
A resposta começa com um diagnóstico (“o OpenSpec está configurado (schema casadei), e ainda não há nenhuma change nem spec”) e segue com uma observação que eu esperava, e que valeu a conversa: a ordem de trabalho está boa, mas as dependências não são lineares. Duas coisas que pareciam “opcionais” no passo 5 dependem de decisões dos passos 2 e 3. Ele desenhou o diagrama em texto; aqui ele está redesenhado:
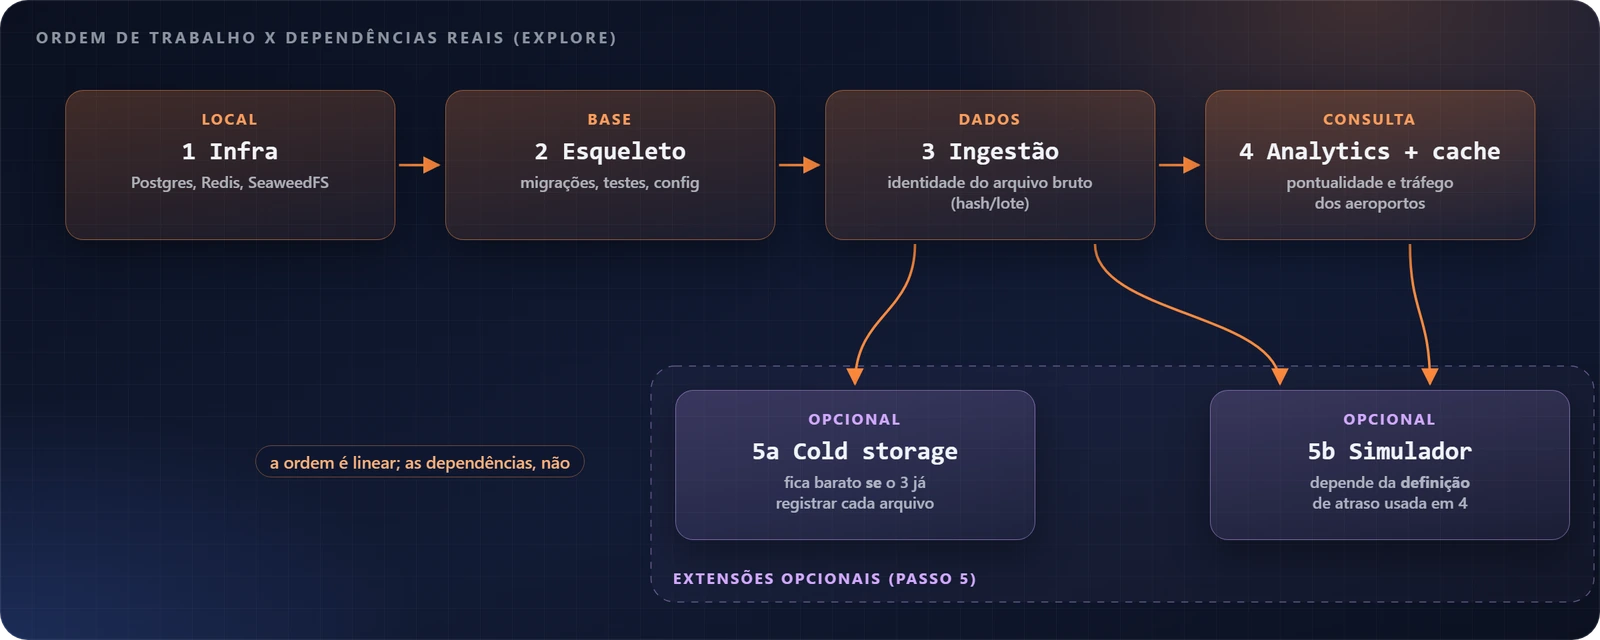
A primeira decisão, que ele mesmo marcou como a mais importante: a ingestão registra cada arquivo de origem numa tabela de lotes, algo como source_file, com caminho, hash do conteúdo, dataset, período, status e data de ingestão, e cada voo aponta para o lote de onde veio. Isso traz idempotência (reprocessar o mesmo arquivo não duplica voos), deixa o cold storage trivial (“subir o arquivo com chave = hash”) e dá de graça uma versão dos dados para invalidar o cache.
É uma decisão de modelagem da ingestão que resolve problemas que só aparecem no analytics e na extensão opcional. Sem essa conversa, a gente descobriria isso tarde e teria que refatorar a ingestão.
⏱ Tempo real: 1 min 33 s (vídeo acelerado).
Sete decisões para travar cedo
O resto da resposta lista mais seis decisões. Resumindo as sete:
| # | Decisão | Por quê |
|---|---|---|
| 1 | Tabela de lotes (source_file) desde a ingestão |
idempotência, cold storage barato, versão dos dados para o cache |
| 2 | Guardar o atraso em minutos e decidir o limiar na consulta | a ANAC usa 15 ou 30 min; o benefício do cartão costuma usar horas |
| 3 | timestamptz e um spike nos arquivos reais para confirmar o fuso |
“Eu não afirmaria isso sem olhar os dados.” |
| 4 | Aeroportos sem FK rígida para a lista brasileira | voos trazem aeroportos estrangeiros fora do cadastro |
| 5 | Esqueleto nasce com Flyway (sem ddl-auto), Testcontainers e pacotes por domínio |
mudar isso depois é doloroso |
| 6 | Redis só como cache, em modo fail-open | se o Redis cair, a consulta vai direto ao Postgres |
| 7 | SeaweedFS só pela API S3, com o AWS SDK, e atrás de um profile no Compose |
o código não fica preso ao produto |
Duas coisas me chamaram a atenção. A primeira é uma pergunta de negócio levantada já agora: “cancelamento conta para o benefício?” Se contar, a situação do voo e a justificativa precisam ser preservadas desde a ingestão. A segunda é a honestidade: ele questionou o Redis que eu mesmo coloquei no plano (“em volume ANAC […] o Postgres com agregados pré-calculados por aeroporto e dia provavelmente já basta. O Redis vale mais como exercício do que como necessidade”) e se recusou a afirmar o fuso dos dados sem vê-los. Um assistente que só concorda não serve para planejar.
Ele fechou com uma sequência levemente reajustada, com um único item novo, o spike nos arquivos reais:
1. Infra (SeaweedFS em profile opcional)
2. Esqueleto: Flyway + Testcontainers + config do caminho do anac-data
3a. Spike: olhar os arquivos reais (colunas, fuso, encoding, separador)
3b. Ingestão: aeroportos + voos + registro de lotes
4. Analytics (atraso em minutos, limiar como parâmetro) + cache versionado
5a. Cold storage   5b. Simulador (independentes entre si)
E com a pergunta que destrava o passo 3: “O que exatamente vai estar no anac-data? Não achei esse repositório na máquina.” Quais conjuntos de dados, em que formato e quantos anos, porque isso decide o modelo da tabela de voos.
⏱ Tempo real: 1 min 28 s (vídeo acelerado).
Nenhuma dessas decisões virou arquivo, e está tudo bem: esse é o papel do explore. Mudar uma decisão de arquitetura custa pouco enquanto ela é só conversa, e custa muito depois que virou tabela, migração e código. O valor está em que elas viram critério de revisão para as próximas propostas. Você vai ver várias delas voltarem nos próximos posts.
Parte 1: o propose da infraestrutura local
Branch desta fase: feat/setup-local-infra/1-propose.
O pedido, em português
Continuei na mesma conversa do explore, então o agente ainda tinha todo aquele contexto. O pedido foi este:
/opsx:propose setup-local-infra

Preciso de um ambiente de desenvolvimento local com docker compose com os serviços essenciais para iniciar.
- PostgreSQL 16, banco "skyledger", usuário e senha "skyledger", exposto na porta 5432, com volume nomeado para persistir dado entre reinicios do container.
- Redis 8 exposto na porta 6379, sem senha (é só para desenvolvimento local por enquanto)
- SeaweedFS, compatível com S3, com bucket criado já na subida do container e volume nomeado.

Isso é exclusivamente para desenvolvimento local, nada disso deve ser tratado como configuração de produção.
O nome logo depois do comando, setup-local-infra, vira a pasta da change em openspec/changes/. O pedido descreve o resultado esperado, não a solução. E deixa de fora, de propósito, várias coisas sobre o SeaweedFS: o nome do bucket, a porta S3 e se o acesso exige credenciais. É um bom teste para o schema: o esperado é que o agente pergunte ou declare as suposições, e não que preencha em silêncio. Também não peço o profile que o próprio explore sugeriu para o SeaweedFS.
⏱ Tempo real: 2 min 50 s (vídeo acelerado).
Antes de escrever, perguntas
A ordem é a que o fluxo pede: primeiro consultar o OpenSpec, depois perguntar, só então escrever.
openspec context --json && openspec new change "setup-local-infra" && openspec status --change "setup-local-infra" --json
openspec instructions proposal --change "setup-local-infra" --json
O openspec new change cria a pasta da change, o status diz em que ordem os artefatos devem ser escritos, e o instructions proposal devolve a instrução do schema casadei para a proposta. Ele não escreve de memória: segue a régua do schema. E aí parou: “Antes de escrever a proposta, dois pontos do SeaweedFS mudam o critério de aceite e a forma como a aplicação vai se conectar depois.”
- Qual nome deve ter o bucket?
skyledger-raw(recomendado, já indica o uso: arquivos brutos da ANAC) ouskyledger(genérico). Escolhiskyledger-raw: conversa direto com o cold storage do explore, e um nome que descreve o conteúdo ajuda quem opera e quem audita. - O endpoint S3 deve exigir credenciais? “Sim, credenciais de dev” (recomendado: “a aplicação já nasce usando o fluxo autenticado que o AWS SDK espera, evitando mudança de código depois”) ou acesso anônimo (mais simples, coerente com o Redis sem senha, mas o cliente teria que mudar depois). Escolhi credenciais de dev. O meu raciocínio: o ambiente local deve se comportar como o real naquilo que afeta o código.
Não são perguntas de formulário. Cada resposta muda um critério de aceite: com credenciais, a spec ganha um requisito de S3 autenticado e outro de sobrescrita das credenciais por variável de ambiente; com o bucket nomeado, o cenário “bucket criado na subida” fica testável.
⏱ Tempo real: 1 min 02 s (vídeo acelerado).
Uma observação honesta: eu esperava uma terceira pergunta, se esta change deveria ter spec ou declarar skip_specs, tratando o ambiente como ferramenta e não como comportamento do produto. Ela não apareceu, e o agente criou direto a spec local-dev-environment. Olhando o resultado, foi uma boa escolha: a spec tem requisitos verificáveis (subida com um comando, persistência, bucket idempotente, acesso só local), e são exatamente esses cenários que o apply vai automatizar como teste.
Proposal, spec e design
Com as respostas, ele escreve os artefatos, sempre no mesmo ritmo: pede ao OpenSpec a instrução e o template do artefato e só então escreve. Como eu estava em modo Manual, cada gravação pediu aprovação:
proposal.md(71 linhas), começando por## Why: motivo e escopo.specs/local-dev-environment/spec.md(150 linhas), um delta spec: a lista do que esta change acrescenta ao comportamento do sistema. Aqui tudo éADDED, porque ainda não existe nenhuma spec.design.md(161 linhas), começando por## Context: as decisões técnicas e o porquê de cada uma.
Na hora das tasks, a instrução do schema avisou: “Before writing tasks, check design.md for Open Questions.” E o agente se corrigiu: “Faltam as tasks. Antes, ajusto no design o lugar da documentação: o padrão do schema pede /docs/, não o README.” O design dele contradizia uma regra escrita, e ele mesmo percebeu. É o tipo de conformidade que, sem schema, dependeria de alguém lembrar na revisão.
Num desses pedidos de edição eu escolhi “Yes, allow all edits this session”, e o modo passou para Edit automatically. Faz sentido quando o padrão está claro e são edições em artefatos que eu ainda vou revisar: as edições continuam visíveis em diff.
⏱ Tempo real: 3 min 18 s (vídeo acelerado).
Tasks, validate e o resumo
Antes das tasks, ele volta à proposta e acrescenta três coisas que eu não pedi explicitamente: o .gitignore, um script de smoke test e a documentação em docs/, mantendo a frase “Nenhum código Java é criado nesta mudança.” Faz isso porque o schema exige que toda mudança traga testes e documentação. Depois vem o tasks.md: 7 grupos, cada um com seus próprios testes e documentação (nada de um grupo “testes” solto no fim). E a validação:
openspec status --change "setup-local-infra" && openspec validate "setup-local-infra" --strict
O resumo final é, para mim, o trecho mais valioso do propose, porque separa o que veio do meu pedido do que foi suposição:
Coisas que acrescentei ou supus, para você revisar:
- Portas só em
127.0.0.1. […] um Redis sem senha e credenciais triviais não deveriam ficar abertos na LAN. Se você precisar de acesso por outra máquina, isso muda o spec.- Porta S3 8333, a padrão do SeaweedFS, já que você não especificou nenhuma.
- Redis sem persistência, porque é só cache e você não pediu volume para ele.
- SeaweedFS sempre ligado. Segui o seu pedido e deixei de lado a minha sugestão anterior de colocá-lo atrás de um
profile.- Documentação em
docs/ambiente-local.md[…]- Testes por um script de smoke test (
scripts/verify-local-env.sh, comcurl --aws-sigv4para o S3), já que ainda não existe build Maven.
E fecha com dois pontos a confirmar na implementação, ambos com plano B no design: se o docker compose up --wait aceita bem um serviço one-shot que cria o bucket e termina, e se o configs.content do Compose (que exige v2.23.1+) está disponível. Guarde esses dois pontos.
O validate --strict é a checagem mecânica: confere estrutura, cenários e formato. Mas ele não sabe se a porta 8333 é o que você quer. Esse julgamento é nosso, e o agente facilita ao deixar as suposições visíveis.
⏱ Tempo real: 1 min 40 s (vídeo acelerado).
Revisando os artefatos em disco
Antes do apply, eu saio do chat e abro os arquivos. Um trecho real da spec, no formato do schema casadei (AS A / WHEN / THEN / AND, com cenário de falha):
### Requirement: Subida do ambiente com um único comando
O repositório SHALL conter, na raiz, um arquivo Docker Compose que sobe
PostgreSQL, Redis e SeaweedFS com um único comando, sem nenhum arquivo de
variáveis de ambiente. Cada serviço MUST expor um healthcheck, de modo que
`docker compose up --wait` só retorne com sucesso quando os três serviços
estiverem prontos para aceitar conexões e o bucket S3 estiver provisionado.

#### Scenario: Porta do host já ocupada
- **AS A** desenvolvedor que já tem outro serviço escutando na porta 5432, 6379 ou 8333
- **WHEN** executo `docker compose up -d --wait`
- **THEN** o comando falha informando qual porta está em conflito
- **AND** os volumes nomeados já existentes não são removidos nem alterados
No design.md, os Non-Goals protegem o escopo: integração com o Spring Boot fica para a change do esqueleto, persistência do Redis não é objetivo, e nada de alta disponibilidade, TLS ou outro endurecimento de produção. Eu não pedi para deixar a aplicação fora do escopo; ele registrou isso sozinho. O design tem 10 decisões (D1 a D10), entre elas tags de imagem fixadas, nunca latest (D2), credenciais S3 geradas pelo Compose via configs.content (D4), bucket criado por um serviço one-shot (D5) e portas só em 127.0.0.1 (D7).
Na proposta, a seção de impacto lista os três segredos de desenvolvimento pelo nome (POSTGRES_PASSWORD, S3_ACCESS_KEY, S3_SECRET_KEY), todos com valores triviais e sobrescrevíveis, diz que nenhum esquema de banco é criado (“as tabelas virão por migrações versionadas no esqueleto”) e avisa sobre possível conflito de portas. E as tasks terminam sempre com uma verificação concreta:
- [ ] 5.2 Confirmar que `docker compose up -d --wait` só retorna depois de `seaweedfs-init`
  terminar com sucesso (D6). Se o Compose tratar a saída do one-shot como falha, aplicar
  o plano B dos Riscos (healthcheck do `seaweedfs` exigindo o bucket) e registrar no
  `design.md`. Verificar com `docker compose up -d --wait` retornando código 0 logo após um `down -v`
Repare como o explore aparece aqui: o bucket de arquivos brutos, a API S3 autenticada, a integração com o Spring Boot deixada para a próxima change. Revisar agora é barato: se a porta, o bucket ou um non-goal estiverem errados, corrige-se um parágrafo, não um compose rodando.
⏱ Tempo real: 59 s (vídeo acelerado).
Parte 2: o apply
Branch desta fase: feat/setup-local-infra/2-apply. Compare com a 1-propose para ver o que mudou no plano ao implementar.
Disparando o apply e conferindo premissas
O pedido inteiro foi:
/opsx:apply
Não expliquei nada de novo, porque tudo o que ele precisa está nos artefatos. Se eu tivesse que repetir o pedido aqui, o propose teria falhado. Como só havia uma change ativa, ele respondeu “Using change: setup-local-infra”.
A primeira ação não foi escrever configuração: foi ler as instruções de apply do schema (“Read context files, work through pending tasks, mark complete as you go. Pause if you hit blockers or need clarification.”) e conferir as versões de Docker, Compose e curl, justamente os pontos que o design deixou em aberto. Resultado: “O ambiente confirma suporte a configs.content e --aws-sigv4 (Docker 29.8, Compose v5.5, curl 8.18).” Um dos dois riscos resolvido antes de qualquer arquivo existir.
Ele também perguntou como o projeto rastreia trabalho, para decidir o nome da branch; respondi “Nenhum, branch simples”. Depois conferiu que as portas 5432, 6379 e 8333 estavam livres, consultou as tags atuais no Docker Hub e decidiu: “Vou usar postgres:16.15, redis:8.10 e chrislusf/seaweedfs:4.48.” Eu pedi “PostgreSQL 16” e ele fixou 16.15: tag fixa é ambiente reproduzível.
Enquanto isso, troquei o modo de permissão para Auto, que aprova sozinho as ações que passam numa checagem de segurança e pausa nas que parecem arriscadas. Num apply que roda dezenas de comandos Docker, isso evita aprovar um por um.
⏱ Tempo real: 1 min 38 s (vídeo acelerado).
Grupos 1 a 3: base, PostgreSQL e Redis
Daqui em diante o ritmo se repete em cada grupo: implementa, testa, documenta, marca o checkbox, e só então passa ao próximo.
- Grupo 1:
.gitignore(comgit check-ignore .envconfirmando),.env.examplecom os três segredos, ocompose.yamlainda sem serviços mas já com o aviso “SOMENTE DESENVOLVIMENTO LOCAL - NÃO USE EM PRODUÇÃO” no topo, edocs/ambiente-local.mdcom um README apontando para ele. - Grupo 2, PostgreSQL: imagem 16.15, porta só em
127.0.0.1, volume nomeado e healthcheck compg_isready. Aqui veio um detalhe que vale ouro: “Notei que a imagem oficial do PostgreSQL confia em conexões locais […] então o teste de senha incorreta precisa ser feito pela porta publicada no host.” Testando de dentro do container, a senha errada seria aceita e o teste não provaria nada. Pela porta do host, a senha certa devolve 16.15 e a errada dápassword authentication failed. E ele usou opsqlda própria imagem, sem instalar nada na máquina. - Nasce o
scripts/verify-local-env.sh, que roda num projeto Compose separado (skyledger-verify), para que os cenários de reset nunca apaguem os dados de desenvolvimento. - O teste de troca de senha explicou um comportamento que confunde muita gente: com volume novo, a senha nova vale; com volume existente, a antiga continua valendo, porque a imagem só aplica a senha ao inicializar um volume vazio. Isso foi para uma tabela na documentação.
- Grupo 3, Redis: 8.10, sem persistência. Ao comparar os volumes antes e depois, ele desconfiou do próprio texto: “Vou confirmar se isso se deve ao
--save ""ou à própria imagem, para o comentário não afirmar algo falso.” A inspeção mostrou que aredis:8.10não declaraVOLUME /data, então a justificativa escrita no design (D8) estava errada. A configuração estava certa; o porquê, não. Ele corrigiu o comentário e o design.
Documentação errada é risco silencioso, e aqui ela foi tratada como defeito.
⏱ Tempo real: 4 min 40 s (vídeo acelerado).
SeaweedFS e o plano B
Este é o trecho mais rico do apply. O serviço seaweedfs entra com S3 ligado, uma única identidade montada via configs, só a porta 8333 publicada e healthcheck. O teste de autenticação com curl --aws-sigv4 dá exatamente o que a spec pede: anônimo, 403; secret errada, 403; credencial válida, a lista de buckets. É o cenário que nasceu da minha resposta no propose.
Depois ele adicionou o seaweedfs-init, o one-shot do plano original, e subiu tudo. Primeira conclusão: “O Compose v5.5 espera o one-shot terminar com código 0 antes de o --wait retornar, então o plano B não foi necessário.” Conclusão tirada de um único teste, em ambiente limpo. O passo seguinte foi testar a segunda subida, que é exatamente o cenário “Subida com bucket já existente” da spec, e ela retornou 1, embora o log mostrasse “bucket skyledger-raw já existe”. Ele reproduziu, mediu (cinco subidas seguidas com o ambiente de pé: 1 1 1 1 1, cinco falhas em cinco) e só então decidiu: aplicar o plano B previsto na task 5.2. O próprio serviço seaweedfs passa a garantir o bucket, e o healthcheck só fica verde depois que ele existe.
No caminho, um tropeço dele mesmo: a primeira reescrita gerou um erro de YAML (“o recorte do meu script casou configs: dentro do próprio serviço, não o bloco de nível superior”). Ele leu o arquivo, removeu o trecho duplicado e revalidou.
⏱ Tempo real: 3 min 39 s (vídeo acelerado).
É aqui que o spec-driven se paga. O risco tinha sido escrito no propose, com plano B e com critério para acioná-lo. Na hora do problema, o agente não precisou improvisar arquitetura nem me perguntar nada: mediu, comparou com o cenário e executou a alternativa que eu já tinha revisado.
Um graceful shutdown que ninguém pediu
Com a subida repetida estável, o reteste revelou outro problema, que não estava em nenhum artefato: “o stop levou 11s e terminou com 137 (SIGKILL)”. O Docker esperou os 10 segundos padrão e matou o processo à força.
O método que ele seguiu merece ser copiado:
- Hipótese: o script de inicialização do plano B não repassa o sinal ao servidor.
- Evidência: a árvore de processos estava correta, com o
weedcomo filho direto dosh. Hipótese descartada. - Medição: com SIGTERM, o próprio
weedlevou 26 s para encerrar com segurança. - Correção:
stop_grace_period: 40s, com um comentário explicando o porquê. - Nova medição: encerramento em 26 s, código 143 (sinal normal, tratado).
Ninguém pediu isso, e não estava no design. Ele chegou lá porque a spec exige que os dados sobrevivam ao reinício, e um SIGKILL no meio da gravação coloca exatamente isso em risco. E não colocou 40 “por garantia”: mediu 26 e escolheu uma margem.
Depois vieram os cenários S3 no script (bucket criado e vazio na primeira subida, acesso com credenciais, 403 para anônimo e secret errada, objeto que sobrevive a derrubar e subir, nova subida com bucket existente) e a suíte inteira: 11 cenários automatizados, todos passando, em cerca de 3 minutos.
⏱ Tempo real: 6 min 02 s (vídeo acelerado).
Fazendo os artefatos dizerem a verdade
A suíte passou, e muita gente pararia aqui. O agente voltou aos artefatos. A D5 do design virou “Bucket garantido pelo próprio serviço seaweedfs (plano B aplicado)”, com a evidência:
*Por que não o one-shot `seaweedfs-init` planejado originalmente:* na
implementação (Compose v5.5.1), `docker compose up -d --wait` retornou 1 em
todas as 5 tentativas de subir de novo um ambiente já de pé
(`container ... seaweedfs-init-1 exited (0)`). Isso viola o cenário "Subida com
bucket já existente". Só a primeira subida, em ambiente limpo, passava.
Os riscos foram atualizados, a task 5.1 reescrita para o mecanismo real, e a documentação ganhou a tabela de uso (subir, ver estado, parar, zerar, logs), o aviso de que parar leva cerca de 25 segundos e exemplos com curl. Ele ainda corrigiu uma afirmação própria: “Corrijo minha afirmação anterior sobre ‘Docker Engine 24+’, que não verifiquei de fato.” A doc passou a dizer “Verificado com 29.8”.
O grupo 6 é a verificação integrada, feita como um humano faria:
- Conflito de porta (6.2): ocupou a 6379 de propósito. O
upfalhou e os volumes ficaram intactos, mas “meu grep casou ‘portchk’ e não a mensagem de erro”. Ele admitiu e repetiu até confirmar que a mensagem cita127.0.0.1:6379. - Só loopback e seguir a doc à risca (6.3 e 6.4): subiu o ambiente real com o comando da documentação, tentou conectar pelo IP de rede (recusado, como esperado) e rodou um a um os exemplos de
curlda doc. Achou um erro: oss -ltnque a doc indicava não mostra as portas neste ambiente. A doc passou a usardocker compose pse a tentativa de conexão.
Fecha com os Quality Gates (Compose válido, bash -n no script, nenhum .env rastreado) e com o próprio OpenSpec confirmando: 29 de 29 tasks, “Change ‘setup-local-infra’ is valid”.
⏱ Tempo real: 4 min 19 s (vídeo acelerado).
Se o design continuasse dizendo “one-shot seaweedfs-init”, ele estaria enganando a próxima pessoa que lesse, inclusive o próprio agente na próxima change. No OpenSpec, o artefato não é rascunho descartável.
O relatório final
O relatório do apply tem a estrutura que eu espero de qualquer um ao fim de uma tarefa, seja pessoa ou agente:
- Resultado: 29 tasks,
validate --strictpassando, 11 cenários em cerca de 3 minutos, e “não fiz commit; os arquivos estão todos não rastreados, esperando você”. - Entregas:
compose.yaml,.env.example,.gitignore, o script de verificação isolado, a documentação e o README. - Desvios do plano, já registrados no design: o one-shot substituído (com as 5 tentativas como evidência), o
stop_grace_periodcom o custo declarado (“Em troca,docker compose downpassou a demorar cerca de 25s”) e as duas afirmações corrigidas. - O que não pôde verificar: os gates Maven ainda não se aplicam, e sem
gitleaksnemshellchecko script passou só nobash -n. Ele não finge cobertura que não tem. - Para você decidir: o SeaweedFS cria buckets automaticamente num PUT de identidade admin (
-s3.autoCreateBucket=true), o que pode esconder um nome de bucket errado na aplicação. “Não mexi porque está fora do spec.” E os volumes de desenvolvimento já existem, criados ao seguir a doc.
⏱ Tempo real: 1 min 42 s (vídeo acelerado).
Esse “não mexi porque está fora do spec” é disciplina de escopo. Se o agente sai corrigindo tudo o que acha estranho, a change deixa de corresponder à proposta revisada. A decisão voltou para mim, que é onde ela deveria estar.
Depois do apply, pedi para organizar o histórico com uma branch por fase (1-propose, 2-apply, 3-archive), que são as branches que você encontra no repositório. A 1-propose traz os artefatos exatamente como estavam ao fim do propose, e a 2-apply tem um commit com a implementação e outro com os artefatos atualizados. Assim, o diff entre as duas mostra o que mudou no plano ao implementar.
Parte 3: o archive
Branch desta fase: feat/setup-local-infra/3-archive.
A pergunta de sync
/opsx:archive
Ao digitar /ops, o menu mostra os comandos instalados: apply, archive, explore, propose, sync e update. Existe um /opsx:sync separado, e o archive oferece fazer o sync junto.
O agente confere o estado (os quatro artefatos done), compara o delta spec com os specs principais e vê que local-dev-environment ainda não existe em openspec/specs/. Então pergunta:
O delta spec local-dev-environment ainda não está nos specs principais (openspec/specs/). Como seguir?
- Sync now (Recommended): Cria openspec/specs/local-dev-environment/spec.md com os 9 requisitos ADDED e o Purpose, verifica, e então arquiva a change.
- Archive without syncing: Só move a change para o archive; o capability não passa a constar nos specs principais.
Vale entender os dois lugares onde uma spec mora no OpenSpec. O delta spec, dentro da change, é só a lista do que muda, com seções ADDED, MODIFIED, REMOVED e RENAMED. Os specs principais, em openspec/specs/, descrevem como o sistema se comporta hoje: são a fonte de verdade.
⏱ Tempo real: 45 s (vídeo acelerado).
Escolhi Sync now, por três motivos. O ambiente que acabamos de construir e testar é exatamente o que a spec descreve. A próxima change, o esqueleto Spring Boot, vai referenciar openspec/specs/ em vez de redefinir portas e credenciais. E um MODIFIED futuro precisa de base: não dá para alterar um requisito que nunca entrou nos specs principais. A analogia que eu uso: Sync now é o merge de um pull request aprovado; Archive without syncing é fechar o PR sem merge, o que faz sentido quando a change foi abandonada ou substituída.
Sync, validação e arquivamento
A execução segue uma ordem de que eu gosto muito:
- Busca as regras de spec do projeto (as três do
config.yaml: dinheiro, REST e dados da ANAC) e conclui que nenhuma se aplica a um ambiente de desenvolvimento. - Cria o spec principal. No delta a seção se chama
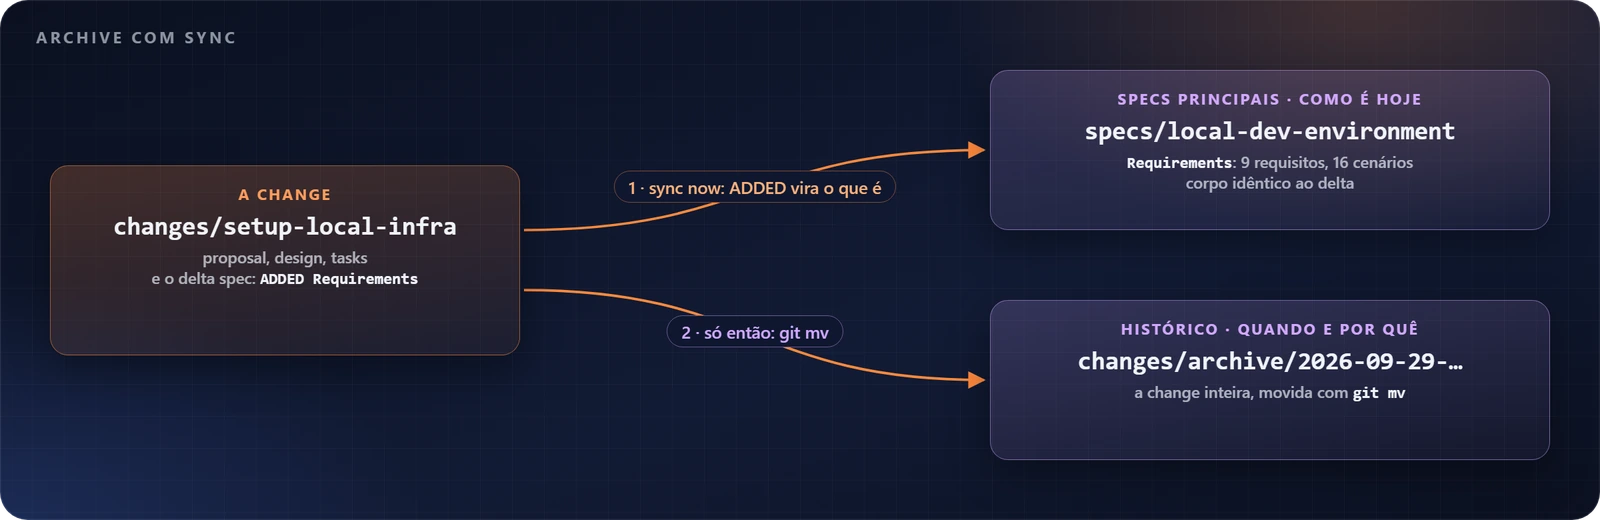
ADDED Requirements; no principal, vira sóRequirements. Aplicar o delta é isso: o “o que muda” vira “o que é”. - Valida: “O spec principal é válido: 9 de 9 requisitos, 16 de 16 cenários, e o corpo é idêntico ao delta.” Promover não é reescrever.
- Só então move a change para
openspec/changes/archive/2026-09-29-setup-local-infra, conferindo antes que o destino não existe, comgit mv, para o git entender que é o mesmo arquivo em outro lugar e o histórico de cada artefato continuar navegável.
Validar antes do passo difícil de desfazer: a mesma lógica de um deploy bem feito.
⏱ Tempo real: 1 min 21 s (vídeo acelerado).
Conferindo com os próprios olhos
Todo relatório de agente é uma afirmação; o arquivo em disco é a prova. No Explorer, openspec/changes/ agora só tem a pasta archive, com a change datada dentro. O tasks.md arquivado está todo marcado, e a task 5.1 registra que “o one-shot seaweedfs-init planejado foi substituído pelo plano B da 5.2”. O desvio do apply não se perdeu no archive.
E o arquivo novo, a fonte de verdade do ambiente local daqui para frente, é openspec/specs/local-dev-environment/spec.md:
## Purpose

Fornece a quem desenvolve o Skyledger BR um ambiente local reproduzível, com
PostgreSQL, Redis e armazenamento de objetos compatível com S3, subido por um
único comando Docker Compose e destinado exclusivamente a desenvolvimento.

## Requirements

### Requirement: Subida do ambiente com um único comando
⏱ Tempo real: 46 s (vídeo acelerado).
openspec/specs/ responde “como o sistema se comporta hoje”; openspec/changes/archive/ responde “quando e por que isso mudou”. Daqui a seis meses, quem perguntar por que o bucket é criado dentro do serviço encontra a resposta, com evidência, no design arquivado. Uma mensagem de commit raramente oferece isso.
Parte 4: testando com as próprias mãos
O agente rodou 11 cenários e seguiu a documentação à risca. Mesmo assim, eu quero ver funcionando, digitando eu mesmo, sem agente nenhum. Três comandos no terminal integrado:
docker compose config
docker compose up -d
docker compose ps
Uma confissão sobre a ordem: o mais seguro é validar e subir antes de arquivar. Se o teste falhar, a change ainda está aberta para corrigir; depois do archive, a correção vira uma change nova. Eu arquivei à noite e testei na manhã seguinte. Funcionou porque o apply já tinha provado os cenários, mas recomendo a ordem segura.
Validando e lendo o compose.yaml
O docker compose config lê o arquivo, resolve as variáveis com os padrões e imprime a configuração final, sem criar nada. Sem nenhum .env, o JSON de identidades do S3 sai com skyledger-dev / skyledger-dev-secret. Depois, uma leitura do compose.yaml que o apply produziu. O serviço do SeaweedFS, com o plano B e o graceful shutdown (trecho):
  seaweedfs:
    # 4.40 é o piso de segurança do projeto (CVEs em versões anteriores).
    image: chrislusf/seaweedfs:4.48
    entrypoint: ["sh", "-c"]
    command:
      - |
        /entrypoint.sh server -s3 -s3.config=/etc/seaweedfs/s3.json &
        pid=$$!
        trap 'kill -TERM "$$pid"; wait "$$pid"; exit' TERM INT
        ...
        # s3.bucket.create falha com bucket existente: listar antes mantém a
        # subida idempotente.
        if shell "s3.bucket.list" | grep -qE '^[[:space:]]*skyledger-raw[[:space:]]'; then
          echo "bucket skyledger-raw já existe"
        else
          shell "s3.bucket.create -name skyledger-raw" || { kill -TERM "$$pid"; exit 1; }
        fi
        touch /tmp/bucket-ready
        wait "$$pid"
    # O weed server leva ~25s no shutdown gracioso; com o padrão de 10s o
    # Docker o mataria com SIGKILL no meio da gravação dos volumes.
    stop_grace_period: 40s
    ports:
      # Só a API S3; master (9333), volume (8080) e filer (8888) ficam internos.
      - "127.0.0.1:8333:8333"
    healthcheck:
      test: ["CMD-SHELL", "test -f /tmp/bucket-ready && wget -q -O /dev/null http://127.0.0.1:8333/healthz"]
Cada linha dá para rastrear até um artefato: as portas em 127.0.0.1 foram uma suposição declarada no propose; o bucket dentro do serviço é a D5 reescrita no apply; o stop_grace_period é o desvio registrado; o aviso no topo atende a um requisito da spec. É isso que torna o arquivo revisável por alguém que não estava na sessão.
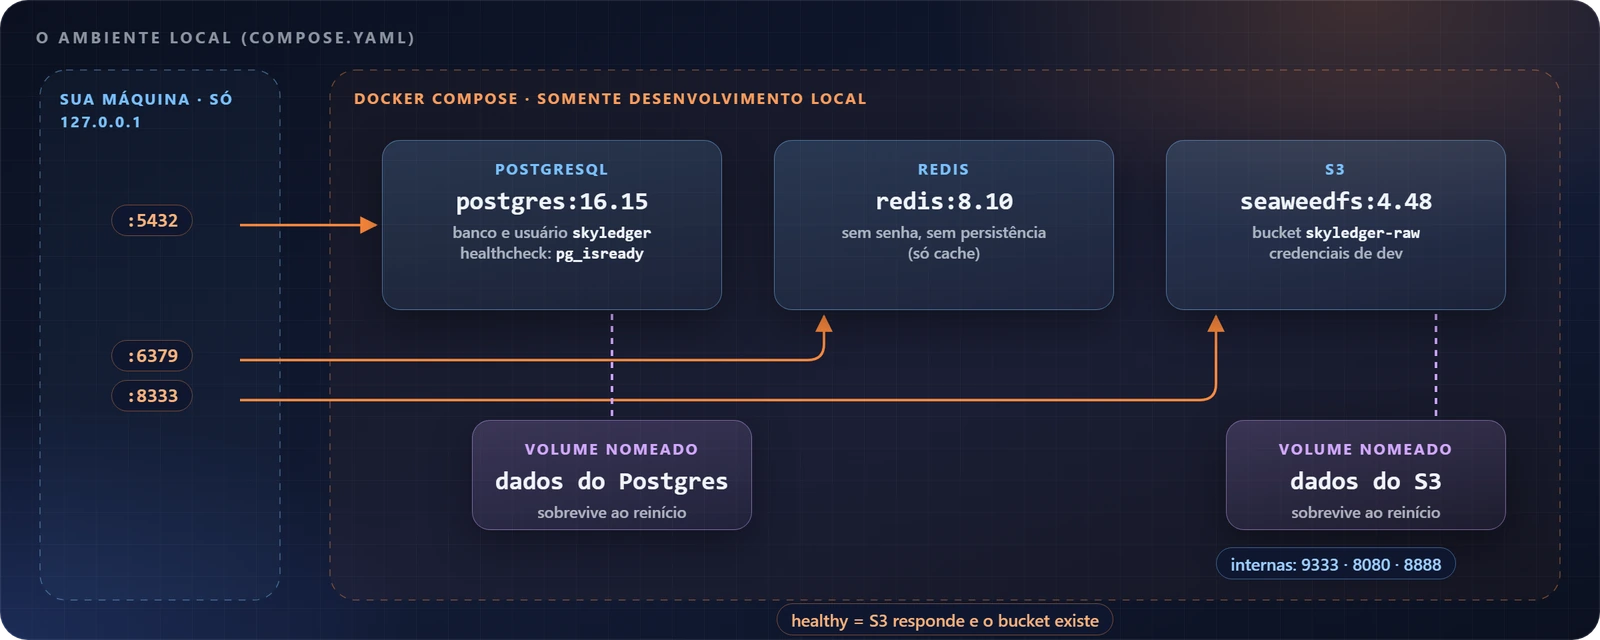
⏱ Tempo real: 44 s.
Subindo: “rodando” não é “pronto”
O docker compose up -d cria a rede e os três containers em menos de um segundo cada. Mas Started quer dizer que o processo começou, não que o serviço está pronto. Repetindo o docker compose ps:
- aos 9 s, Postgres 16.15 e Redis 8.10 já estão
healthy, e o SeaweedFS aparece comohealth: starting; - aos 18 s, ainda
starting. Na coluna de portas dele, 7333, 8080, 8888, 9333 e outras aparecem só como internas; a única publicada no host é127.0.0.1:8333; - aos 29 s, os três
healthy.
E healthy aqui quer dizer que o S3 responde e o bucket skyledger-raw existe, porque é isso que o healthcheck exige (decisão D6). Por causa disso, o comando que a documentação recomenda, docker compose up -d --wait, só retorna quando tudo está realmente pronto, e um script de CI pode confiar nele sem sleep fixo.
⏱ Tempo real: 42 s (vídeo acelerado).
Se você está acompanhando a série, este é o seu checkpoint: rode os mesmos três comandos no seu clone e confirme os três healthy. A infraestrutura precisa estar de pé no próximo post, porque o Spring Boot tenta conectar no Postgres já na inicialização.
Lições desta primeira change
- O explore é o lugar barato para errar. Nenhum arquivo foi criado, mas as decisões dele (bucket de arquivos brutos, S3 autenticado, Flyway, tabela de lotes) atravessam a série inteira.
- Pergunta antes de suposição, suposição declarada antes de silêncio. As duas perguntas do propose mudaram critérios de aceite, e o resumo separou o que era meu do que era dele.
- Risco escrito com plano B vira decisão, não improviso. O one-shot falhou exatamente onde o design dizia que podia falhar, e a saída já estava revisada.
- A spec orienta decisões que o prompt nunca mencionou. O
stop_grace_periodsaiu do requisito de persistência, não de um pedido meu. - Artefato que mente é defeito. O apply corrigiu o design, a doc e até afirmações dele mesmo antes de declarar pronto.
- Confira em disco e com as próprias mãos. O relatório é uma afirmação; o
docker compose psé a prova.
E o principal: usamos o ciclo inteiro para algo que nem é código de aplicação. Nada entra no projeto sem um combinado revisado antes, nem um arquivo de configuração.
Referências
- Spec-Driven Development
- OpenSpec · Documentação
- openspec-casadei, o meu schema público para o OpenSpec
- O projeto
- skyledger-br · branches desta change:
1-propose,2-apply,3-archive - anac-data · Dados e estatísticas da ANAC
- skyledger-br · branches desta change:
- Ferramentas
- Claude Code
- Docker Compose ·
configs·healthcheck·stop_grace_period·docker compose up --wait - PostgreSQL (imagem oficial) · Redis (imagem oficial) · SeaweedFS · SeaweedFS: API S3
- curl
--aws-sigv4 - Mencionados no explore: Flyway · Testcontainers · Spring Boot
Navegação da série: ← Parte 1: OpenSpec, schema casadei e Claude Code · Parte 3: o esqueleto Spring Boot do SkyLedger →
Se este post te ajudou a destravar o seu primeiro ciclo de SDD, me conta no LinkedIn (linkedin.com/in/vcasadei) ou confira outros textos em vcasadei.com.