 It looks like you prefer English. Would you like to view this page in English?
A primeira feature de verdade do SkyLedger: trazer os voos da ANAC para o PostgreSQL, medindo os dados antes de decidir qualquer coisa.
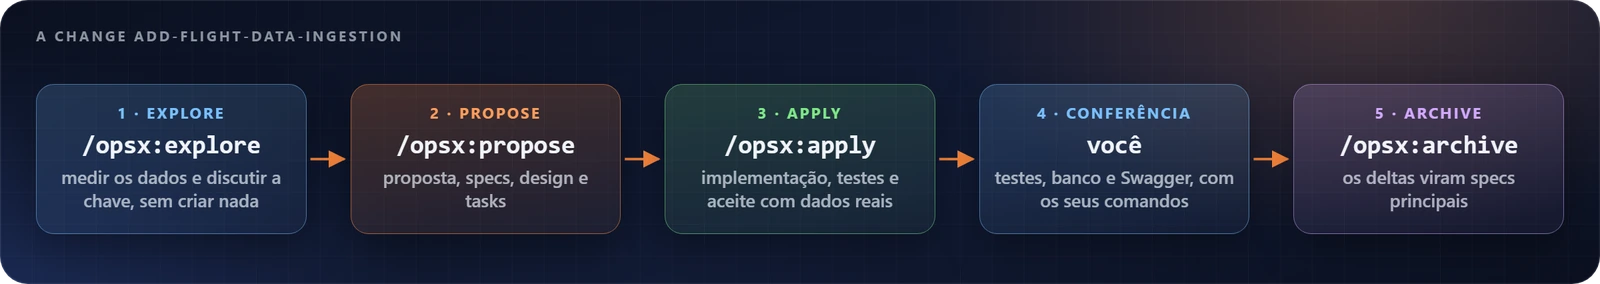
Este artigo faz parte de uma série de posts para ensinar Spec-Driven Development com o OpenSpec, do zero, usando um projeto real: o SkyLedger BR, uma aplicação Spring Boot que trabalha com os dados abertos de aviação civil da ANAC. Cada post cobre uma change completa, do explore ao archive, com os prompts reais, as perguntas que o agente fez e as decisões que eu tomei.
- SDD com OpenSpec, parte 1: OpenSpec, schema casadei e Claude Code
- SDD com OpenSpec, parte 2: SkyLedger BR e a infraestrutura local
- SDD com OpenSpec, parte 3: o esqueleto Spring Boot do SkyLedger
- SDD com OpenSpec, parte 4: ingestão dos dados abertos da ANAC no SkyLedger (você está aqui)
- SDD com OpenSpec, parte 5: a API de consulta de voos do SkyLedger
Até aqui, o SkyLedger tem um ambiente local com Docker Compose (parte 2) e uma aplicação Spring Boot que sobe, conecta no PostgreSQL e responde ao health-check (parte 3). Cada uma dessas changes deixou o seu spec arquivado em openspec/specs. O que ainda não existe é nenhuma tabela no banco e nenhuma regra de negócio.
Este post é o mais denso da série, porque dado real tem armadilha. A primeira linha de cada arquivo não é o cabeçalho. Existem voos realizados com o horário previsto vindo como a palavra null. E a chave que eu tinha na cabeça para identificar um voo estava errada. Tudo isso só apareceu porque a gente mediu os arquivos antes de escrever a spec.
Como nos outros posts, eu gravei tudo, no VS Code com o Claude Code e o schema openspec-casadei. Os vídeos estão acelerados nas esperas e na digitação.
De onde vêm os dados: ANAC e o repositório anac-data
A fonte oficial
A ANAC (Agência Nacional de Aviação Civil) publica os seus dados abertos no portal sistemas.anac.gov.br/dadosabertos. Não espere um catálogo amigável: é uma listagem crua de diretórios. Os dois conjuntos que interessam aqui são:
- VRA (Voo Regular Ativo), em Voos e operações aéreas → Voo Regular Ativo (VRA) → ano → mês. Um arquivo por mês, com uma linha por etapa de voo: companhia, número do voo, origem e destino em código ICAO, partida e chegada previstas e reais, e a situação (
REALIZADOouCANCELADO). Atraso e cancelamento saem direto dele. - Aeródromos Públicos, em Aerodromos → Aeródromos Públicos → Lista de aeródromos públicos. O cadastro que transforma
SBRJem “Santos Dumont, Rio de Janeiro, RJ”, com município, UF, coordenadas e altitude.
Por que existe um repositório só para os dados
Baixar direto do portal não é trivial. A ANAC cria antecipadamente as pastas dos meses que ainda não foram publicados (e elas ficam com datas de modificação mais recentes do que as pastas que têm dados), e já mudou o padrão de nome dos arquivos mais de uma vez. Para o SkyLedger não depender de um download manual, eu montei um repositório separado: o anac-data.
Ele faz três coisas:
- Baixa de forma reproduzível. Uma ferramenta em Python, só com a biblioteca padrão (nada de
pip), lê as listagens do portal, escolhe os N meses mais recentes que têm arquivo, e faz downloads retomáveis e verificados. Nenhum nome de arquivo é fixo no código: tudo segue os links da própria listagem. - Guarda os dados no git. Clonou, os CSVs estão lá: três meses do VRA (maio a julho de 2026) e o cadastro de aeródromos. Um arquivo estatístico opcional, grande demais para o git, vai em pedaços comprimidos com scripts de reconstrução.
- Registra a procedência. O
data/raw/anac/manifest.jsonguarda, por arquivo, a URL de origem, o tamanho, o SHA-256, oETage a data “Atualizado em”.
git clone https://github.com/vcasadei/anac-data.git
cd anac-data
PYTHONPATH=src python3 -m anac_data fetch --dry-run   # mostra o que baixaria, sem baixar
PYTHONPATH=src python3 -m anac_data inspect           # mede delimitador, encoding e linha do cabeçalho
O README do anac-data tem uma seção que eu considero a mais importante do repositório: “Reading the CSVs (do this before writing a parser)”. Ela lista fatos medidos nos bytes, não supostos: delimitador ;, VRA em UTF-8 com BOM, cadastro em Latin-1 (ISO-8859-1), cabeçalho na linha 2 e o null literal nos horários. Esses fatos são o ponto de partida deste post.
No SkyLedger, o anac-data fica clonado ao lado do projeto, e a aplicação aponta para ele pela variável ANAC_DATA_PATH=../anac-data.
Parte 1 — Explore: medir antes de escolher a chave
Primeiro, olhar o arquivo real
Antes de pedir qualquer coisa ao Claude, eu abro o dado de verdade. No terminal, com os três repositórios lado a lado (anac-data, openspec-casadei e skyledger-br), entro no anac-data e imprimo só as três primeiras linhas do arquivo de julho:
cd anac-data
sed -n '1,3p' data/raw/anac/vra/VRA_20267.csv
A linha 1 é Atualizado em: 2026-08-28: metadado, não cabeçalho. A linha 2 é o cabeçalho de verdade, com 12 campos entre aspas separados por ponto e vírgula. A linha 3 já é um voo: GLO 1015, de SBRJ para SBSP, partida prevista às 10:30, real às 10:24, REALIZADO.
Um parser que lê a linha 1 como cabeçalho produz uma única coluna de lixo e não dá erro nenhum. É o tipo de defeito silencioso que só aparece quando alguém olha os números no fim.
⏱ Tempo real: 1 min 28 s (vídeo acelerado).
O prompt do explore
O /opsx:explore é o modo de pensar junto: ele não cria change, não escreve proposta e não toca em código. Por isso é o lugar certo para perguntas abertas. Este é o texto que eu mandei, com os meus erros de digitação (“ANAX”, “mes”, “voce”):
/opsx:explore agora eu quero ingerir os arquivos CSV do VRA (Voo Regular Ativo) da ANAX no banco. São 3 arquivos mensais, um por mes. Fatos medidos por eles, não suposições: delimitador";", encoding UTF-8 com BOM e a linha 1 de cada arquivo é metadado ("Atualizado em :..."). O cabeçalho fica na linha 2. As colunas trazem aeroporto de origem/destino (código ICAO), horário previsto e realizado de partida/chegada e situação de voo, que pode ser REALIZADO ou CANCELADO.
Um detalhe: podem existir linhas REALIZADO com "Partida Prevista" como uma string literal "null", que são voos que operaram sem horario previsto registrado, não são cancelamentos. Preciso popular tabelas de aeroporto, companhia aerea e voo, sem duplicar registros se o mesmo arquivo for processado de novo (alguns voos do fim do mes aparecem também no arquivo do mes seguinte).
Antes de propor a mudança: como voce trataria as linhas como "null" literal, como estruturaria o parser considerando o cabeçalho na linha 2 e qual seria a chave natural para evitar duplicar um voo já importado?
Repare na estrutura: fatos que eu vi no terminal, a armadilha que eu conheço (o null que não é cancelamento), o que eu preciso (três tabelas, sem duplicar) e três perguntas abertas. Não há nenhum verbo de implementação. Se eu mandasse a solução pronta, por exemplo “use número do voo mais data como chave”, o Claude provavelmente seguiria, e eu perderia a chance de ele medir os dados e me contradizer.
Um detalhe de bastidor: eu continuei na mesma sessão do Claude Code usada nas partes 2 e 3, parada há quase um dia. O Claude Code avisou que o cache do prompt tinha expirado e que a próxima mensagem iria recarregar cerca de 305 mil tokens. O ganho é que ele ainda lembrava das decisões anteriores; o custo foi o medidor de uso da sessão pular de 0% para 14% logo no envio. Abrir uma sessão nova sai mais barato, mas exige que as decisões estejam escritas em algum lugar. É um trade-off que vale conhecer.
⏱ Tempo real: 4 min 27 s (vídeo acelerado).
O Claude mede antes de responder
A primeira frase dele já mostra a atitude certa: “Antes de responder, vou ver se o anac-data já está acessível. Assim respondo com as colunas reais, sem supor.” Em seguida vem uma sequência de comandos, todos de leitura: localizar o anac-data, rodar openspec list (nenhuma change ativa), ler o README, conferir os três primeiros bytes (efbbbf, o BOM do UTF-8) e a linha de metadado.
Depois vêm scripts de profiling sobre os três arquivos inteiros: quantos null por coluna e por situação, se os null andam juntos, se algum campo tem ; ou aspas internas, e — o mais importante — quantas colisões cada chave candidata produz. A saída que decide a chave é esta:
k1 emp+num+orig+coalesce(PP,PR): chaves com linhas DIFERENTES dentro do arquivo: 15
k2 emp+num+orig+PP+PR: ... 0
Com a partida real dentro da chave, as colisões vão a zero. Nada foi criado em openspec/changes: o explore continua sendo só conversa.
⏱ Tempo real: 4 min 05 s (vídeo acelerado).
O que os dados mostraram (e a premissa que caiu)
A resposta abre assim: “Medi os três arquivos reais no anac-data (252.756 linhas no total). Os números confirmam os fatos que você trouxe, mas mudam duas premissas e acrescentam detalhes que o parser precisa tratar.”
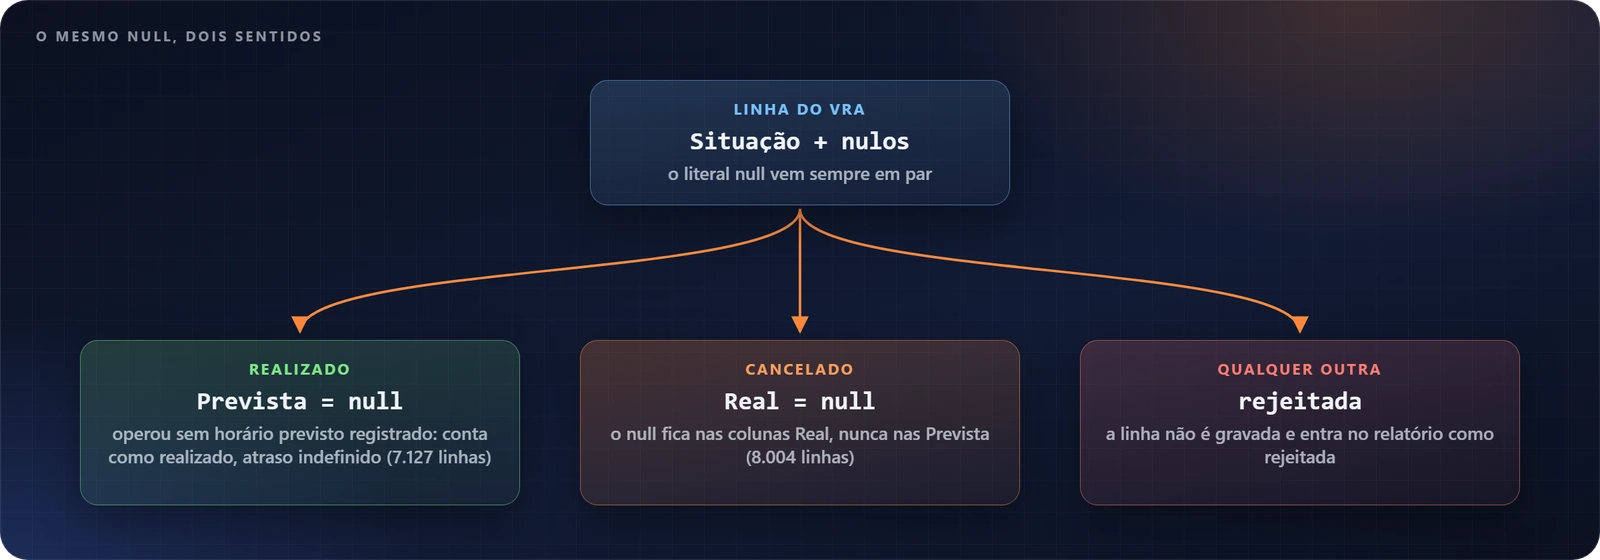
- O
nullvem sempre em par. Partida e Chegada Prevista nulas juntas, em 7.127 linhasREALIZADO. - O
nullmuda de sentido. Nos 8.004CANCELADO, onullestá nas colunas Real, nunca nas Prevista. “O mesmo literal significa outra coisa conforme a situação.” - Frações de segundo nos horários. 39.792 valores com
.100000000, que quebrariam um parser rígido em 8% das linhas. - Número do voo é texto, por causa de valores como
Z9672e0073. - Formato regular: CRLF, 12 campos sempre entre aspas, nenhum
;ou aspa dentro de valor.
E a premissa corrigida. Eu tinha escrito que voos do fim do mês reaparecem no arquivo seguinte. Ele mediu: só 2 linhas se repetem entre maio e junho, e nenhuma entre junho e julho. O risco real estava dentro de cada arquivo: 29 linhas duplicadas byte a byte e 15 pares com o mesmo voo previsto e dois horários reais diferentes, como o ACA 0091 de SBGR para CYYZ. “São inconsistências da própria ANAC.” Com a minha premissa, a deduplicação teria sido desenhada para o caso errado.
Para o null, ele propõe uma tabela que cruza a situação com os nulos: REALIZADO com prevista nula é um voo que operou sem horário previsto registrado (conta como realizado, atraso indefinido); CANCELADO tem a parte Real nula; qualquer outra combinação é linha rejeitada e reportada. Para o parser, etapas simples: remover o BOM, validar a linha de metadado, mapear o cabeçalho por nome, ler linha a linha e gravar em lotes. Como o formato é regular, um parser pequeno e estrito resolve “sem nova dependência”; uma biblioteca CSV “precisaria de aprovação”. É a regra do schema casadei sobre dependências novas aparecendo já no explore.
⏱ Tempo real: 1 min 40 s (vídeo acelerado).
A chave natural: A ou B?
Esta é a parte que eu mais quero que você leve. O Claude testou as chaves contra os dados e apresentou a escolha como um trade-off:
| Opção A | Opção B | |
|---|---|---|
| Chave | companhia, número, origem, COALESCE(prevista, real) |
companhia, número, origem, prevista, real, com NULLS NOT DISTINCT |
| Semântica | “um voo programado = uma linha” | cada operação publicada = uma linha |
| A favor | dá para atualizar a mesma linha se a ANAC corrigir um horário | zero perda; reprocessar é idempotente |
| Contra | nos 15 pares divergentes, uma operação é descartada ou sobrescrita | uma correção de horário real entraria como voo novo |
E um detalhe técnico que eu não teria lembrado sozinho: “no PostgreSQL, NULL não colide numa UNIQUE comum”. Sem tratar isso, os cancelados e os voos sem horário previsto seriam duplicados a cada reprocessamento. A cláusula UNIQUE NULLS NOT DISTINCT existe a partir do PostgreSQL 15, “e temos o 16”.
A recomendação dele foi a B: o ponto fraco não aparece nos dados (os três arquivos têm o mesmo “Atualizado em: 2026-08-28”), e, se aparecer, a tabela de lotes mostra qual arquivo trouxe cada linha. Antes da pergunta final, ele ainda listou os pontos que iam aparecer no propose: a ferramenta de migração (o esqueleto deixou o Flyway de fora, e “um Flyway ou Liquibase seria dependência nova, que precisa da sua aprovação”), se os aeroportos seriam só os códigos do VRA ou enriquecidos com o cadastro, companhias só com o código ICAO, fuso horário (guardar como publicado) e como disparar a ingestão.
A conversa termina com a pergunta em aberto: “você fica com a opção B (prevista + real, NULLS NOT DISTINCT) ou prefere a semântica ‘um voo programado = uma linha’ da opção A?”. A resposta define a restrição de unicidade, o comportamento de reprocessamento no spec e os cenários de teste.
⏱ Tempo real: 1 min 09 s (vídeo acelerado).
Eu fiquei com a B. Ela atende literalmente ao que eu pedi: reprocessar não duplica, e nada é perdido nem inventado. Aceitei um risco hipotético (correção retroativa) para evitar uma perda real e medida (15 pares). Vale registrar também a diferença em relação ao que eu tinha planejado: eu imaginava uma chave do tipo “número do voo, data e aeroporto de origem”. Os dados mostraram que isso não basta, e só medindo dava para descobrir.
Parte 2 — Propose: da conversa aos artefatos
Branch para conferir: feat/add-flight-data-ingestion/1-propose.
A decisão vai no prompt
A conversa do explore não grava nada em disco. Por isso a decisão vai explícita no prompt do propose. O que eu enviei, com os erros de digitação:
/opsx:propose add-flight-data-ingestion
seguindo o que foi discutido, vou seguir com a opcao B. Com essas informações, contrua a proposta
A primeira linha traz o nome da change em kebab-case, que vira a pasta em openspec/changes. A segunda traz a decisão. Para ser honesto: escrever só “opção B” funcionou porque a sessão era a mesma e a opção estava logo acima. Numa sessão nova, “opção B” não significaria nada. O mais seguro é escrever a decisão por extenso: a chave é companhia, número, origem, partida prevista e partida real, com UNIQUE NULLS NOT DISTINCT, e o motivo.
A resposta: “Opção B registrada.” E ele avisa que vai perguntar as decisões que deixamos em aberto, “porque elas mudam escopo, dependências e contrato”. Antes disso, confere o estado do repositório e dá uma olhada no AerodromosPublicos.csv, já trazendo um fato novo: o cadastro usa ISO-8859-1, campos sem aspas e coordenadas com vírgula decimal, “o que exigiria um segundo parser e aumentaria o escopo”. O custo de uma opção chegou antes de eu decidir.
⏱ Tempo real: 2 min 06 s (vídeo acelerado).
Quatro decisões antes de escrever
O Claude abre um formulário com quatro abas, exatamente os pontos listados no fim do explore. Cada opção traz o custo escrito ao lado:
| Pergunta | Opções | Minha escolha |
|---|---|---|
| Migrações (dependência nova) | Flyway (recomendada): SQL puro, versão gerenciada pelo Spring Boot, sem “undo” na edição gratuita · Liquibase: rollback declarativo, mais verboso | Flyway |
| Aeroportos | Só códigos do VRA (recomendada): menor escopo · Enriquecer com o cadastro: nome, município, UF e coordenadas dos 496 aeródromos, ao custo de um segundo parser | Enriquecer |
| Disparo | Endpoint REST (recomendada), com relatório por arquivo · comando na inicialização · os dois | Endpoint REST |
| Parser | Parser próprio estrito (recomendada) · Apache Commons CSV, mais tolerante mas dependência nova | Parser próprio |
Duas regras do schema casadei aparecem juntas aqui. Dependência nova precisa ser nomeada e aprovada, por isso Flyway, Liquibase e Commons CSV viraram perguntas, e não decisões silenciosas. E a pergunta vem antes do artefato: se eu discordar, ninguém precisa reescrever proposta.
Nos aeroportos eu fui contra a recomendação, de propósito. Um aeroporto que é só “SBGR” serve pouco para as análises que vêm depois; eu quero nome, cidade e UF. O custo estava escrito, e eu aceitei. Recomendação é insumo, não ordem.
⏱ Tempo real: 1 min 14 s (vídeo acelerado).
Medindo o cadastro de aeródromos
A minha escolha colocou no escopo um arquivo que não tinha sido medido. O Claude mede o cadastro com o mesmo rigor do VRA: sem BOM, não decodifica como UTF-8, outra linha de metadado (Atualizado em: 2026-09-15), campos sem aspas, separadores decimais diferentes para coordenadas e altitude, UF por extenso, 31 aeródromos interditados.
E aqui ele erra uma conta e percebe: “ao ler em modo texto, o Python converte \r\n em \n, então meu split(‘\r\n’) deixou o conjunto do cadastro vazio. Refaço”. Relendo em modo binário, o resultado correto:
cadastro 496 | VRA 289 | em ambos 153 | fora: brasileiros 6 estrangeiros 130 | cadastro sem voo no VRA: 343
Ou seja, dos 289 aeroportos do VRA, 130 são estrangeiros e 6 são brasileiros fora do cadastro: a tabela de aeroportos precisa aceitar aeroporto só com código. Erro de medição admitido é ótimo; erro silencioso é que vira spec errado.
Só depois de medir ele cria a change, com openspec new change add-flight-data-ingestion, e confere no Maven Central que o spring-boot-starter-flyway existe para a versão do Spring Boot do projeto.
⏱ Tempo real: 2 min 20 s (vídeo acelerado).
O conflito com um spec que já existia
Este é o trecho que melhor mostra por que specs vivos valem a pena. Na parte 3, o esqueleto deixou arquivado o spec application-runtime, que garante que a aplicação inicia mesmo com o PostgreSQL fora do ar. O Flyway, por padrão, aplica as migrações na subida, e sem banco a aplicação não sobe. O Claude leu o spec antes de propor e parou:
O spec application-runtime garante que a app inicia com o PostgreSQL fora, mas o Flyway padrão migra na inicialização e falha sem banco. Como resolver?
- Migrar na subida, mudar o spec (recomendada): falha rápida, esquema sempre pronto; o requisito de inicialização recebe um
MODIFIED, e só o Redis continua opcional. - Manter o spec, migrar depois: a aplicação sobe sem banco e migra em segundo plano, com retry, e a ingestão devolve 503 até o esquema ficar pronto. Custo: “código próprio de orquestração e mais cenários”.
Escolhi a primeira. Para uma aplicação cuja razão de existir é o banco, subir sem esquema é pior do que não subir. Mas o mais importante não é qual opção eu escolhi: é que a escolha não foi silenciosa. Sem o spec arquivado, o Flyway entraria, a aplicação deixaria de subir sem banco, e alguém descobriria isso achando que era bug.
⏱ Tempo real: 50 s (vídeo acelerado).
Escrevendo e validando os artefatos
Com tudo decidido, o Claude escreve na ordem do OpenSpec: proposta, specs, design e tasks. Dois detalhes chamam a atenção.
Os números de aceite são calculados antes de serem escritos. Pela chave B, maio deve inserir 82.102 voos (18 duplicatas), junho 81.117 (2) e julho 89.506 (11): “pela chave B são 252.725 voos distintos no total”. Depois, 87 companhias e 632 aeroportos (496 do cadastro e 136 só do VRA). Até o tipo das colunas nasce de medição: latitude com até 9 casas decimais leva a NUMERIC(12,9).
O validador estrito pega um erro. No delta do application-runtime, o openspec validate --strict reclama que o MODIFIED “omits scenario(s) the current spec still has”: o requisito alterado esqueceu um cenário que o spec atual tem. Ele corrige mantendo o cenário e reescrevendo só o resultado, e revalida: Change 'add-flight-data-ingestion' is valid. Um MODIFIED que apaga um cenário sem querer seria uma perda silenciosa de contrato.
⏱ Tempo real: 7 min 05 s (vídeo acelerado).
O que ficou escrito
A proposta resume o escopo e marca a quebra de compatibilidade:
- **Chave natural do voo:** (empresa, número do voo, aeroporto de origem,
  partida prevista, partida real), com valores ausentes tratados como iguais
  entre si. Duplicatas exatas dentro do arquivo, reprocessamentos e a
  sobreposição entre meses não geram registro novo.
- **Endpoint `POST /api/ingestions`**: processa o cadastro e depois os
  arquivos do VRA do `anac-data`, e devolve um relatório por arquivo (linhas
  lidas, inseridas, duplicadas e rejeitadas).
- **BREAKING** (comportamento de inicialização, capability
  `application-runtime`): a aplicação passa a aplicar as migrações ao iniciar e
  **não inicia mais com o PostgreSQL indisponível** ...
O spec novo, flight-data-ingestion, tem 8 requisitos. Os cenários seguem o formato AS A / WHEN / THEN / AND que o schema casadei exige, com cenários de falha:
### Requirement: Voo sem duplicação pela chave natural
Cada voo SHALL ser identificado pela chave natural (empresa, número do voo,
aeroporto de origem, partida prevista, partida real), em que valores ausentes
são considerados iguais entre si. ...

#### Scenario: Reprocessamento do mesmo arquivo
- **AS A** operador que já ingeriu todos os arquivos
- **WHEN** envio `POST /api/ingestions` de novo
- **THEN** cada arquivo do VRA reporta `inserted` `0` e `duplicates` igual a `rowsRead`
- **AND** o número de voos no banco continua 252725
O delta do application-runtime começa com um RENAMED, porque o nome antigo deixaria de ser verdade:
## RENAMED Requirements

- FROM: `### Requirement: Inicialização independente da disponibilidade das dependências`
- TO: `### Requirement: Inicialização com esquema migrado e Redis opcional`
O design traz 10 decisões, o DDL completo e o plano de migração com rollback. As tasks são 39, em 8 grupos, cada uma com a sua verificação. Um exemplo do grupo de aceite:
- [ ] 7.1 Com `ANAC_DATA_PATH=../anac-data`, banco recriado (`docker compose down -v` e `up`)
  e a aplicação no ar, `POST /api/ingestions` responde 200 com o cadastro `inserted` 496 e os
  VRA `inserted`/`duplicates` = 82102/18, 81117/2 e 89506/11, `rejected` 0 em todos, em menos
  de 2 minutos
Revisar antes de aplicar
O resumo final do propose é organizado de um jeito que eu gostaria de ver em qualquer entrega: os artefatos, as minhas decisões e como entraram, as “decisões técnicas que valem sua revisão” (as que ele tomou sozinho) e os “pontos que ficaram como risco no design”. Entre as decisões dele: contagens feitas pelo banco (staging e INSERT ... SELECT ... ON CONFLICT DO NOTHING), rollback fora do Flyway num db/rollback/V1__down.sql com teste, e testes num schema separado, skyledger_test. Entre os riscos: ingestão síncrona com meta de menos de 2 minutos, e o hikari.schema ainda não verificado com a conexão do Docker Compose.
Aqui eu cometi o meu erro desta change. O texto não diz onde roda o PostgreSQL dos testes. Eu tinha anotado a pergunta: é um container isolado, com Testcontainers, ou a mesma instância do Docker Compose usada no dia a dia? Não perguntei e segui para o apply. Guarde isso: a consequência aparece no fim do apply.
⏱ Tempo real: 1 min 20 s (vídeo acelerado).
Parte 3 — Apply: implementação com aceite real
Branch para conferir: feat/add-flight-data-ingestion/2-apply.
/opsx:apply
Sem argumento nenhum. Vale olhar este passo com uma pergunta na cabeça: o que acontece quando a realidade discorda do plano? Porque vai discordar, e mais de uma vez.
Grupo 1: Flyway, migração e rollback
“Using change: add-flight-data-ingestion”: ele descobre sozinho qual change aplicar, porque é a única ativa, e confere o estado (0 de 39 tasks, PostgreSQL com status healthy). Depois:
- adiciona o Flyway no
pom.xml(“O Flyway 12.4.0 entrou”); - escreve a migração
V1__create_ingestion_schema.sqlcom as cinco tabelas e o script que a desfaz,db/rollback/V1__down.sql; - configura os testes para usarem o schema
skyledger_test, com um comentário explicando que, sem isso, os testes “gravariam fixtures no schema public do banco de desenvolvimento”; - confirma o risco que tinha ficado aberto:
current_schema()retornouskyledger_test, então ohikari.schemafunciona com a conexão do Docker Compose; - testa o rollback num schema descartável: aplica, desfaz e aplica de novo;
- ajusta os testes antigos que simulam banco fora do ar (agora precisam desligar o Flyway) e cria um teste novo: sem PostgreSQL, a inicialização falha;
- atualiza o
docs/aplicacao.mddizendo que o PostgreSQL precisa estar de pé antes da aplicação.
O coração da migração é a restrição que veio do explore:
-- NULLS NOT DISTINCT: cancelados (sem partida real) e realizados sem partida
-- prevista também não podem se repetir a cada reprocessamento.
CONSTRAINT flight_natural_key UNIQUE NULLS NOT DISTINCT
    (airline_icao, flight_number, origin_icao, scheduled_departure, actual_departure),
O schema casadei exige plano de rollback para toda migração, e aqui ele não é um comentário: é um script com teste automatizado. Exige também testes e documentação em cada grupo, antes do próximo. Não existe uma fase “documentar no final”.
⏱ Tempo real: 5 min 35 s (vídeo acelerado).
Grupos 2 a 4: fonte configurável e parsers estritos
O caminho dos arquivos vira configuração: skyledger.anac-data.path, alimentada pela variável ANAC_DATA_PATH, sem valor padrão no código. Os testes de resolução usam um diretório temporário, nada de arquivo real.
Pelo caminho, pequenas autocorreções: um record chamado Files colidia com a classe Files do Java e virou SourceFiles; os dois parsers repetiam a mesma exceção interna, que virou uma InvalidValueException compartilhada. E um acréscimo declarado: “Acrescentei uma validação não prevista no plano: como flight_number é varchar(10) no banco, o parser rejeita linhas com números de voo maiores, evitando que isso derrube o arquivo inteiro na inserção.”
Os testes dos parsers usam conteúdo em memória, porque a regra do projeto proíbe caminho real dos dados nos testes automatizados. Mas parser estrito só se prova contra o dado real. Então ele roda os dois parsers contra os arquivos do anac-data “via um script jshell descartável no scratchpad, para confirmar 0 rejeições sem expor caminhos reais nos testes”. Primeiro resultado: VRA_20265 com 82.120 linhas válidas e 0 rejeitadas.
⏱ Tempo real: 6 min 05 s (vídeo acelerado).
O dado real contradiz o spec
O VRA passou limpo. O cadastro, não:
O VRA real passou sem rejeições, mas o cadastro teve a linha 109 rejeitada por Altitude vir como ‘,0’, contradizendo o número 496 usado no spec. Vou inspecionar essa linha antes de decidir como proceder.
É o aeroporto SBMI, de Maricá, com altitude ,0. Ele procura no arquivo inteiro (altitudes sem parte inteira: [',0'] | zero explícito: []): caso único, e não existe nenhum zero escrito do jeito normal. Interpreta o ,0 como “um dado ausente mal exportado em vez de 0,0 m” e, em vez de dar um jeito no código, pergunta: “Como isso afeta a spec e os critérios de aceite, preciso que você decida como tratar esse caso”.
- Gravar sem altitude (recomendada): não inventa valor, mantém nome e coordenadas e o aceite de 496.
- Interpretar como 0,0: mais simples, mas grava um valor provavelmente errado. Um valor errado é pior do que um ausente, porque ninguém desconfia dele depois.
- Rejeitar a linha: coerente com a regra existente, mas joga fora um aeroporto inteiro por um campo e muda o aceite para 495.
Escolhi gravar sem altitude. É o mesmo princípio do null do VRA: ausente é ausente, não é zero. E repare no valor do critério de aceite com número exato: “carregar o cadastro” não teria pego nada; “496 aeródromos” pegou.
⏱ Tempo real: 1 min 55 s (vídeo acelerado).
A decisão vai para o spec; depois, persistência e endpoint
“Decidido: gravar sem altitude. A regra fica ‘altitude vazia ou sem parte inteira = ausente’. Atualizo o parser, o teste, o spec (texto do requisito e cenário novo) e o design.” Quatro lugares, não um. O spec ganhou um cenário:
#### Scenario: Altitude sem parte inteira
- **AS A** operador
- **WHEN** a ingestão processa o aeródromo `SBMI`, com `Altitude` igual a `,0`
- **THEN** o aeroporto é gravado com nome, município, UF e coordenadas, e sem altitude
A change é validada de novo, e o cadastro real passa com validas=496 rejeitadas=0.
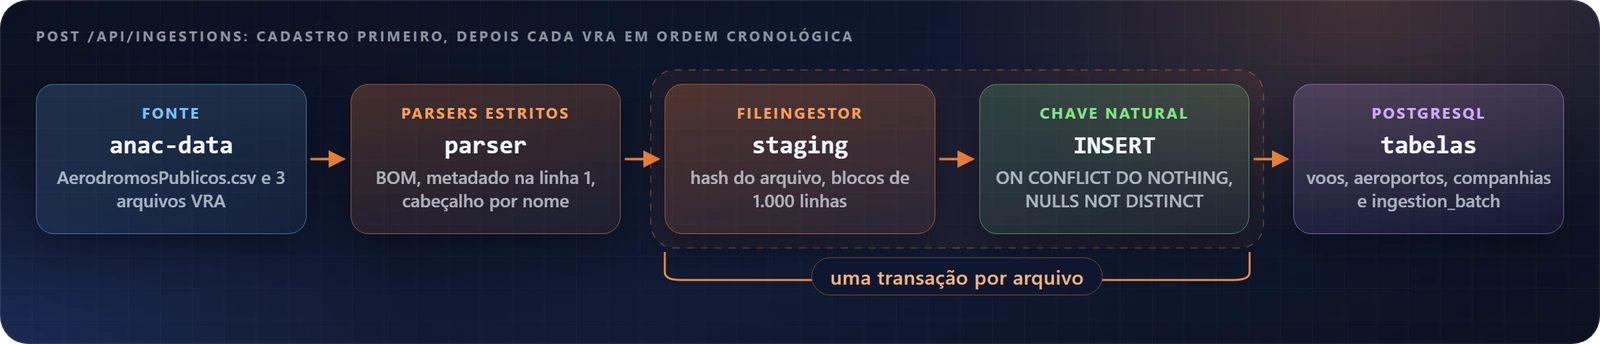
Nos grupos 5 e 6 vêm os repositórios JDBC, o FileIngestor (hash do arquivo, tabela de staging, blocos de 1.000 linhas, uma transação por arquivo), o IngestionService (lock contra execuções simultâneas e ordem dos arquivos), o controller e o tratamento de erros com ProblemDetail. Momentos que valem destaque:
- Autocorreção de design: “Percebi que deixei estado mutável (sequence) num repositório singleton”. Ele troca o contador pela linha física do arquivo, que já é única e crescente.
- Fixtures com bytes certos: o cadastro de teste em ISO-8859-1 com CRLF, o VRA em UTF-8 com BOM, e um
.gitattributespara o git não converter esses bytes no checkout. - Erro no teste, não no código: 11 testes, 2 erros, porque o
singleValue()não aceita resultado nulo, e nulo era justamente o que ele queria verificar. Corrige o teste. - “0 testes” não é sucesso: com
@Nested, a classe externa reporta 0 testes, e ele vai aos relatórios confirmar que as classes aninhadas rodaram de fato. - Documentação no mesmo grupo: teste da OpenAPI gerada,
docs/ingestao.md,docs/aplicacao.mde o README.
⏱ Tempo real: 12 min 05 s (vídeo acelerado).
Aceite com os dados reais
O grupo 7 pede o aceite com os arquivos de verdade, então o próprio Claude sobe a aplicação e chama o endpoint. Antes, ele avisa duas escolhas: não vai rodar docker compose down -v (que apagaria os volumes), porque o schema public já está vazio, e vai passar o ANAC_DATA_PATH na linha de comando, sem mexer no .env.
O primeiro POST /api/ingestions responde 404. A reação: “O endpoint respondeu 404, embora os testes passem. Antes de supor qualquer coisa, olho o corpo da resposta e qual processo está na porta 8080”. A causa: um processo antigo, de testes manuais anteriores, preso na porta 8080 com código desatualizado. Ele mata o processo e tenta de novo.
Confirmei a etapa 7.1: os números batem com os dados do explore (496; 82102/18; 81117/2; 89506/11; 0 rejeições), concluída em 26,8 s, bem dentro da meta de 2 minutos.
A segunda ingestão confirma a idempotência: reprocessar não insere nada. Mas a task 7.2 não bateu: ela pedia 7.127 voos sem horário previsto e 8.004 cancelados. Ele reconta direto nos arquivos, só os voos distintos pela chave (distintos: 252725 | sem prevista: 7125 | cancelados: 8000), e conclui que a task estava errada: os números do planejamento eram linhas brutas, com duplicatas. Ele corrige o texto da task, em vez de ajustar a medição para caber nela:
- [x] 7.2 Conferir no banco: 252725 voos, 87 companhias, 632 aeroportos (496 com `in_public_registry`),
  7125 voos `REALIZADO` sem partida prevista e 8000 `CANCELADO` (corrigido no apply: os 7127/8004 do
  planejamento eram linhas brutas, com duplicatas; sobre voos distintos pela chave, o recálculo dá 7125/8000)
Na task 7.4, ele segue o docs/ingestao.md como um usuário seguiria, inclusive acrescentando ANAC_DATA_PATH ao .env local, e roda as consultas SQL documentadas com um id de lote real.
⏱ Tempo real: 5 min 50 s (vídeo acelerado).
O verify falha, e o vazamento aparece
Último gate: provar que os testes não tocam os dados de desenvolvimento. Em vez de recriar o banco com down -v, o que “apagaria a ingestão real feita no public”, ele compara as contagens do public antes e depois do ./mvnw verify. O public ficou intacto, mas o verify falhou: o SchemaMigrationTest e o StartupWithoutDatabaseTest.
A segunda falha era uma asserção estreita demais (a causa direta da exceção mudou por causa da ordem de criação dos beans). A primeira era séria. O teste de rollback trocava o schema da conexão com um comando SQL e depois desfazia com RESET. Só que o RESET volta ao padrão do servidor, que é o public. Resultado: o pool de conexões recebia de volta uma conexão apontando para o banco de desenvolvimento. A correção: Connection.setSchema(...), que o pool sabe restaurar, e uma proteção em toda rotina de TRUNCATE dos testes, que falha se o schema da conexão não for skyledger_test. O achado foi registrado no design.
”./mvnw verify passou com 73 testes e 0 falhas.” Ele ainda confere que não há caminho fixo para os dados no código nem .env rastreado, procura segredos antes de commitar, faz dois commits (implementação e artefatos do OpenSpec) e confere que o remoto ficou no mesmo hash do local.
Agora ligue isso ao propose. A pergunta sobre Testcontainers não foi feita, a resposta acabou sendo “mesma instância do Compose, outro schema”, e o risco se materializou. Nada foi apagado, porque o gate existia. Mas uma pergunta de um minuto no propose virou uma correção no fim do apply.
⏱ Tempo real: 4 min 30 s (vídeo acelerado).
O relatório de entrega
O resumo final do apply é um registro de aceite:
| Arquivo | Lidas | Inseridas | Duplicadas | Rejeitadas |
|---|---|---|---|---|
AerodromosPublicos.csv |
496 | 496 | 0 | 0 |
VRA_20265.csv |
82.120 | 82.102 | 18 | 0 |
VRA_20266.csv |
81.119 | 81.117 | 2 | 0 |
VRA_20267.csv |
89.517 | 89.506 | 11 | 0 |
No banco: 252.725 voos, 87 companhias e 632 aeroportos, em 26,8 s. 39 de 39 tasks, ./mvnw verify com 73 testes.
E três seções que eu passei a exigir de qualquer entrega:
- “O que a implementação corrigiu no plano”, cada item registrado no design ou nas tasks: o SBMI sem altitude, os números da 7.2, o vazamento de schema e o
hikari.schemaconfirmado. - “Acréscimos pequenos, fora do texto das tasks”: o limite de 10 caracteres no número do voo, a configuração do problem details para o erro 405 e o
.gitattributesdas fixtures. - “O que você deve saber sobre o seu ambiente”: não rodou
down -v; opublicde dev agora tem os dados reais; acrescentouANAC_DATA_PATH=../anac-dataao.env(local, fora do git); encerrou a instância antiga na porta 8080, “Era ela que causava um 404 falso”.
⏱ Tempo real: 1 min 47 s (vídeo acelerado).
Parte 4 — Conferindo com os meus comandos
Relatório de agente não é prova. Prova é o número no meu terminal batendo com o que foi prometido. Então, sem pedir nada ao Claude, eu confiro.
Começo relendo o fim do relatório e abrindo a migração gerada. Ao lado de db/migration está a pasta rollback. No meio do arquivo, a tabela ingestion_batch (dataset, arquivo, sha256, contagens): é a procedência de cada arquivo ingerido, pronta para responder “de qual arquivo veio este voo e quando ele foi carregado”.
⏱ Tempo real: 30 s.
Migrações e suíte de testes
ls src/main/resources/db/migration/
./mvnw -q test
Uma change, uma migração: V1__create_ingestion_schema.sql. Na suíte, o log mostra BeanCreationException e “Error starting ApplicationContext” no meio. Não se assuste: são os testes de caminho de falha, em que a aplicação precisa recusar a subida (sem credencial, por exemplo). O schema casadei exige pelo menos um cenário de falha por requisito, e é isso que aparece no log. A linha que importa é a do Flyway dizendo que o schema skyledger_test está atualizado: os testes rodam isolados do schema de desenvolvimento. Com o -q, silêncio no fim é sucesso.
⏱ Tempo real: 2 min 22 s (vídeo acelerado).
Subindo a aplicação
./mvnw spring-boot:run
(Na gravação eu digitei sprint- antes de corrigir. Ao vivo também se erra.) O banner mostra o Spring Boot 4.1.1 com Java 21, o Flyway aplica a migração no banco de desenvolvimento e o Tomcat sobe na 8080: “Started SkyledgerApplication in 16.56 seconds”. Logo abaixo, dois avisos do SpringDoc lembrando que /v3/api-docs e /swagger-ui.html estão habilitados por padrão e que em produção convém desligar. É um item para decidir antes do primeiro deploy.
Teste verde não é a mesma coisa que aplicação subindo: subir de verdade valida o .env, a conexão com o Postgres do Compose e o requisito novo do application-runtime, que agora exige o esquema migrado.
⏱ Tempo real: 1 min 08 s (vídeo acelerado).
Contando no banco, e o 404 proposital
docker compose exec postgres psql -U skyledger -d skyledger -c "SELECT count(*) FROM flight;"
docker compose exec postgres psql -U skyledger -d skyledger -c "SELECT * FROM airport LIMIT 5;"
252725. Bate exatamente com o relatório e com o número calculado no propose. Os aeroportos aparecem com código ICAO, CIAD, município, UF por extenso, coordenadas, altitude e a situação “Cadastrado”: o cadastro da ANAC já dentro do banco.
Depois eu faço de propósito o que eu queria como usuário: ver os voos de Guarulhos por HTTP.
curl -s "http://localhost:8080/flights?airport=GRU" | jq .
Status 404, "detail": "No static resource flights.", no formato problem+json. Não é bug. A change só faz a carga; consulta nunca esteve na proposta nem no spec. Quem conhece o escopo lê o 404 como “isso ainda não foi combinado”. Quem não conhece acha que algo quebrou. Essa é a diferença que o spec faz.
⏱ Tempo real: 35 s (vídeo acelerado).
O Swagger mostra só o que foi prometido
Em http://localhost:8080/swagger-ui.html, duas seções: Ingestão, com o POST /api/ingestions, e Actuator, com o health-check. A descrição do POST, em português, sem que eu pedisse de novo:
Processa AerodromosPublicos.csv e depois cada VRA_.csv em ordem cronológica, um por transação. Idempotente: reprocessar não duplica registros (contados em duplicates).
Cada frase corresponde a uma decisão do explore ou do propose. A resposta 409, “Já existe uma ingestão em andamento”, também está documentada. E não há nenhum /flights: a documentação confirma o que o curl mostrou. Os dados estão no banco, conferidos e documentados, mas ninguém de fora consegue vê-los sem um psql aberto. Essa lacuna é a motivação da próxima change.
⏱ Tempo real: 31 s.
Parte 5 — Archive
Branch para conferir: feat/add-flight-data-ingestion/3-archive.
Um pedido fora do escopo
Antes de arquivar, eu faço ao Claude a pergunta que qualquer pessoa de negócio faria, informal e sem o vocabulário certo:
nesse propose foi feito só a inserção dos dados? eu gostaria por exemplo da criação de um endpoint http://localhost:8080/flights?airport=GRU onde eu poderia ver os voos desse aeroporto
O caminho fácil seria enfiar um controller na mesma entrega. Ele faz o contrário. Explica que a change “cobriu só a carga dos dados” e que o /flights “hoje responderia 404. Isso é intencional pelo escopo que definimos”. E aponta o detalhe que muda o desenho: “GRU é código IATA, e os nossos dados só têm ICAO”. O VRA e o cadastro usam SBGR. Consultar por ICAO não precisa de nenhum dado novo; por IATA, precisaria de uma fonte nova de mapeamento, com ingestão e aprovação.
Ele ainda antecipa as decisões da próxima change (paginação, porque Guarulhos tem dezenas de milhares de voos; sentido, partidas, chegadas ou ambos; atraso só quando há os dois horários) e recomenda arquivar a ingestão primeiro, para a consulta ser construída sobre specs já sincronizados. Fecha com um lembrete: “Explore mode e propose só planejam; nada é implementado até o /opsx:apply.”
⏱ Tempo real: 45 s (vídeo acelerado).
O texto da próxima proposta
Em vez de responder sobre ICAO, eu peço o rascunho:
ok, vou rodar o archive, me dê o texto para essa nova proposal.
O que volta é um /opsx:propose add-flight-query-api pronto para colar: GET /flights?airport=SBGR em ICAO (com a alternativa IATA marcada como “não incluir nesta change”), direction (DEPARTURE, ARRIVAL ou BOTH), período com from e to, filtro de situação, paginação obrigatória com tamanho máximo, atraso em minutos, horários sem conversão de fuso, erros 400 e 404 em problem+json, OpenAPI, testes no schema isolado e, no fim, “Somente leitura: não altera as tabelas nem a ingestão existentes.”
Meu pedido vago, “quero ver os voos de GRU”, virou uma lista de requisitos verificáveis. É uma técnica que eu recomendo: deixar o agente, que já conhece o banco, os specs e as armadilhas, redigir o pedido, e revisar antes de enviar. Esse texto é o ponto de partida da parte 5.
⏱ Tempo real: 45 s (vídeo acelerado).
/opsx:archive e a checagem do estado
/opsx:archive
*“Using change: add-flight-data-ingestion (to archive a different one, run /opsx:archive
⏱ Tempo real: 37 s (vídeo acelerado).
Sync now, agora alterando um spec existente
A pergunta de todo archive, com uma diferença: é a primeira vez no projeto que o sync altera um spec que já existia, e não só cria um novo.
- Sync now (recomendada): cria o
flight-data-ingestione aplica oRENAMEDe os doisMODIFIEDnoapplication-runtime. - Archive without syncing: só move a change. O próprio aviso diz a consequência: o
application-runtime“continuaria prometendo subir sem PostgreSQL”.
Escolhi Sync now. Um spec que promete algo que o código não faz é pior do que spec nenhum, porque engana com autoridade.
O que me impressionou foi a verificação depois do script de merge. O Claude não confia no próprio script: confere que os 8 requisitos ADDED (34 cenários) ficaram idênticos ao delta, que o nome antigo do requisito não aparece mais, que os dois MODIFIED estão idênticos ao delta, e que os outros 5 requisitos do application-runtime não mudaram em relação à versão anterior do arquivo. Só então move a change para openspec/changes/archive/2026-10-01-add-flight-data-ingestion e faz o commit.
⏱ Tempo real: 1 min 33 s (vídeo acelerado).
O estado final dos specs
O resumo final traz a frase que justifica o archive inteiro:
Com isso, o spec deixou de prometer que a aplicação sobe sem PostgreSQL.
Os specs principais agora são três, todos válidos no validate --strict: local-dev-environment (9 requisitos), application-runtime (7) e flight-data-ingestion (8). A change foi movida com git mv, então o histórico dos arquivos continua visível, e não há nenhuma change ativa. Para conferir no seu clone:
git checkout feat/add-flight-data-ingestion/3-archive
ls openspec/specs
ls openspec/changes/archive
openspec list --specs
⏱ Tempo real: 21 s (vídeo acelerado).
O que fica
- Meça antes de especificar. A pergunta “o que os dados mostram?” derrubou a minha premissa sobre a sobreposição entre meses e a chave que eu tinha na cabeça. A chave natural define a restrição no banco, o comportamento de reprocessamento e os cenários de teste. Errar ali custa caro depois.
- Explore é conversa; a decisão precisa ir para o disco. Escreva a decisão no prompt do propose por extenso, não “opção B”.
- Dependência nova e mudança de comportamento viram pergunta. Flyway, Commons CSV e a quebra do
application-runtimeforam decididos por mim, com o custo escrito ao lado. - Specs arquivados são contrato. Foi o spec da parte 3 que fez o conflito com o Flyway aparecer no propose, e não num ambiente qualquer.
- Critério de aceite com número exato pega desvio. O 496 pegou o SBMI; o 252.725 deu uma conferência número contra número.
- Quando o dado contradiz o artefato, corrija o artefato, por escrito. SBMI no spec, a 7.2 nas tasks, o vazamento de schema no design.
- Revise o propose de verdade. A pergunta do Testcontainers que eu pulei voltou como correção no fim do apply. Na próxima change, eu faria essa pergunta antes.
No próximo post, a parte 5, os voos finalmente saem do psql: a API de consulta, começando pelo texto que o Claude rascunhou aqui, com duas mudanças minhas.
Navegação da série: ← Parte 3: o esqueleto Spring Boot do SkyLedger · Parte 5: a API de consulta de voos do SkyLedger →
Referências e links úteis
- Spec-Driven Development
- OpenSpec · Documentação
- openspec-casadei, o meu schema público para o OpenSpec
- SDD com opencode e modelos gratuitos do InkStone, se você quiser praticar sem ferramenta paga
- SkyLedger BR
- Repositório
- Branches desta change:
1-propose·2-apply·3-archive
- Dados
- Portal de dados abertos da ANAC
- anac-data, o repositório que baixa e versiona os dados de forma reproduzível
- Tecnologias
Se este post te ajudou a entender como o SDD se comporta com dado real, me conta no LinkedIn (linkedin.com/in/vcasadei) ou confira outros projetos e textos que publico em vcasadei.com.