 It looks like you prefer English. Would you like to view this page in English?
Um passo a passo, do zero, para praticar spec-driven development com o opencode e os modelos gratuitos do InkStone.
Nos últimos meses eu tenho usado (e ensinado) Spec-Driven Development com o OpenSpec. A ideia é simples e, para mim, mudou a forma de trabalhar com agentes de código: antes de qualquer linha de código, a gente escreve e revisa o que vai ser feito. Proposta, requisitos, design e tarefas viram arquivos Markdown versionados, e só depois o agente implementa.
Uma pergunta que eu sempre recebo é: “como praticar isso em casa, sem gastar nada?”. Este artigo é a minha resposta: o fluxo completo de SDD com o OpenSpec, rodando com o opencode, um agente de código open source, e modelos gratuitos como o DeepSeek V4 Pro, servidos pela plataforma InkStone (Intern Discovery).
Eu gravei cada passo. Os vídeos estão acelerados nas esperas, e embaixo de cada um eu deixo quanto tempo aquilo levou de verdade. Isso é importante: o serviço é gratuito, mas não é rápido.
O que vamos montar
- Uma WSL dedicada, chamada
sdd-lab: um Ubuntu rodando dentro do Windows só para este estudo. Se algo der errado, você apaga e recria sem afetar mais nada. (No Linux ou no macOS, pule esta parte e siga do Node.js em diante.) - opencode: agente de código open source, que roda no terminal e conversa com qualquer provedor compatível com a API da OpenAI.
- Intern Discovery / InkStone: a fonte dos modelos gratuitos (mais detalhes na próxima seção).
- OpenSpec: o framework de spec-driven development, com o meu schema público openspec-casadei por cima.
- Um primeiro spec de verdade: um CLI chamado
wordcount, em Node.js, que conta linhas, palavras e caracteres de um arquivo. Simples o bastante para caber num artigo, completo o bastante para passar pelo ciclo inteiro.
O ciclo do OpenSpec que vamos rodar é este:
O que é o InkStone (e por que é gratuito, por enquanto)
O Intern Discovery, também chamado de InkStone (书生·端砚), é uma plataforma do Shanghai AI Laboratory voltada para pesquisa científica: ferramentas para artigos, espaços por tema, aplicações de pesquisa, dados e computação científica. No meio disso tudo, no menu Research Models, ela oferece acesso por API a modelos de linguagem como DeepSeek V4 Pro, DeepSeek V4 Flash, GLM 5.3, Kimi K2.6 e Qwen, com endpoints compatíveis com a API da OpenAI e com a da Anthropic.
No momento em que escrevo, esse acesso está gratuito, com cota por janela de tempo, e o menu aparece com a etiqueta Free. Eu não sei por quanto tempo isso vai durar: não encontrei nenhuma data ou política pública sobre o fim da gratuidade. Então trate como uma oportunidade temporária para estudar. Se um dia deixar de ser gratuito, nada do que você montou se perde: o opencode aceita qualquer provedor compatível com a API da OpenAI, e trocar de provedor é mudar a URL e a chave no opencode.json. O próprio opencode também lista alguns modelos gratuitos dele no /models.
Antes de começar: segurança e expectativas
Use uma conta GitHub descartável
O cadastro na plataforma é feito com login pelo GitHub. Eu recomendo fortemente criar uma conta GitHub nova, só para isso, com um e-mail separado do pessoal e do de trabalho. O login via OAuth pede acesso aos dados do perfil (“Personal user data — Full access”), e com uma conta descartável você não expõe sua conta principal, seus repositórios nem seus vínculos com organizações.
Duas regras a mais:
- Nada de código, dados ou segredos do trabalho. O serviço é hospedado fora do Brasil, sob outras leis de proteção de dados. Trate como ambiente de estudo.
- A API key é pessoal. Ela fica num arquivo com permissão só para você, nunca no repositório, nunca colada em chat.
Gratuito, mas não é rápido
O ciclo completo do wordcount levou, no relógio, cerca de 10 minutos no propose, 6 minutos no apply e 5 minutos no archive. Com modelos pagos e mais rápidos, o mesmo exercício leva uma fração disso. Para estudar, funciona muito bem; para o dia a dia de trabalho, a velocidade pesa.
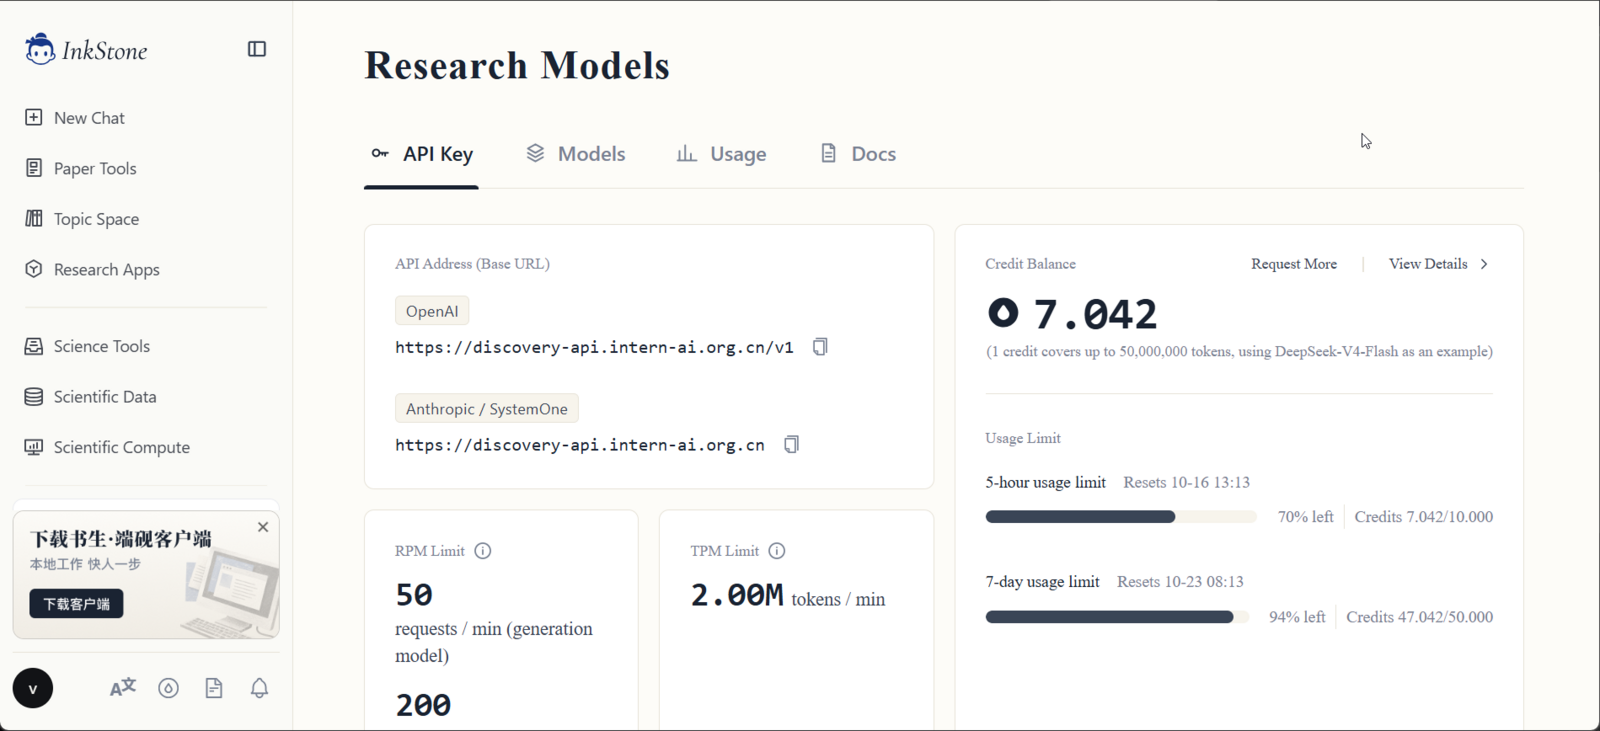
E a cota dá conta: o exercício inteiro, do cadastro ao archive, consumiu cerca de 30% do limite de 5 horas e 6% do limite semanal da conta gratuita.
Parte 1 — Conta e API key
Entrando no Intern Discovery
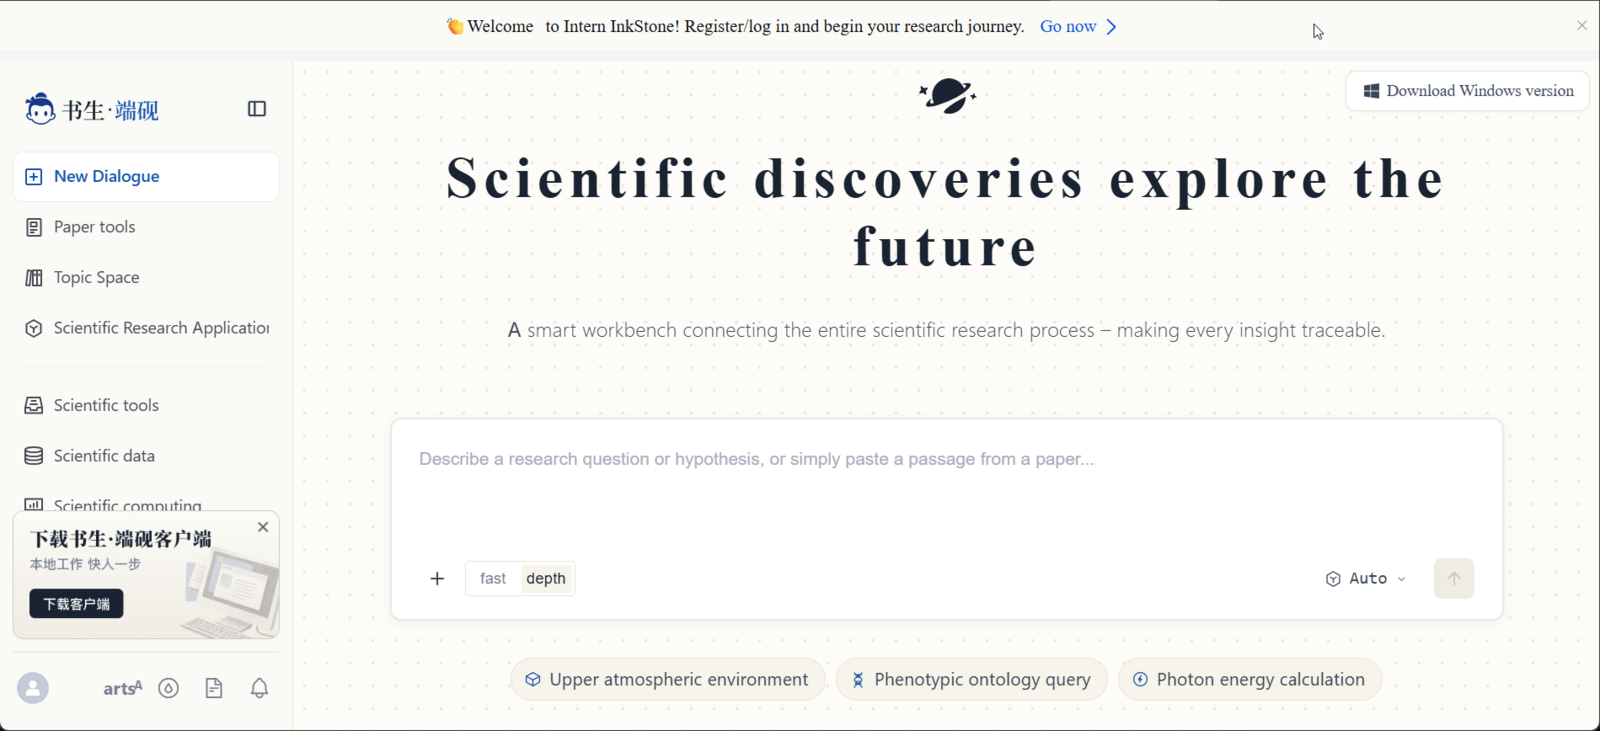
A página inicial abre em chinês, mas tem a opção de inglês no canto superior direito (o tradutor do navegador também resolve).
Um aviso que vai te poupar tempo: a plataforma oferece cadastro por e-mail, mas o firewall do site bloqueia esse cadastro. O botão simplesmente não faz nada, e o console do navegador mostra um erro 405 Method Not Allowed, com uma página de bloqueio do firewall da Alibaba Cloud. Eu testei com outros navegadores, janela anônima, outra rede e VPN, e o bloqueio continuou. O login com GitHub funciona, então vá direto por ele, em More login options → GitHub.
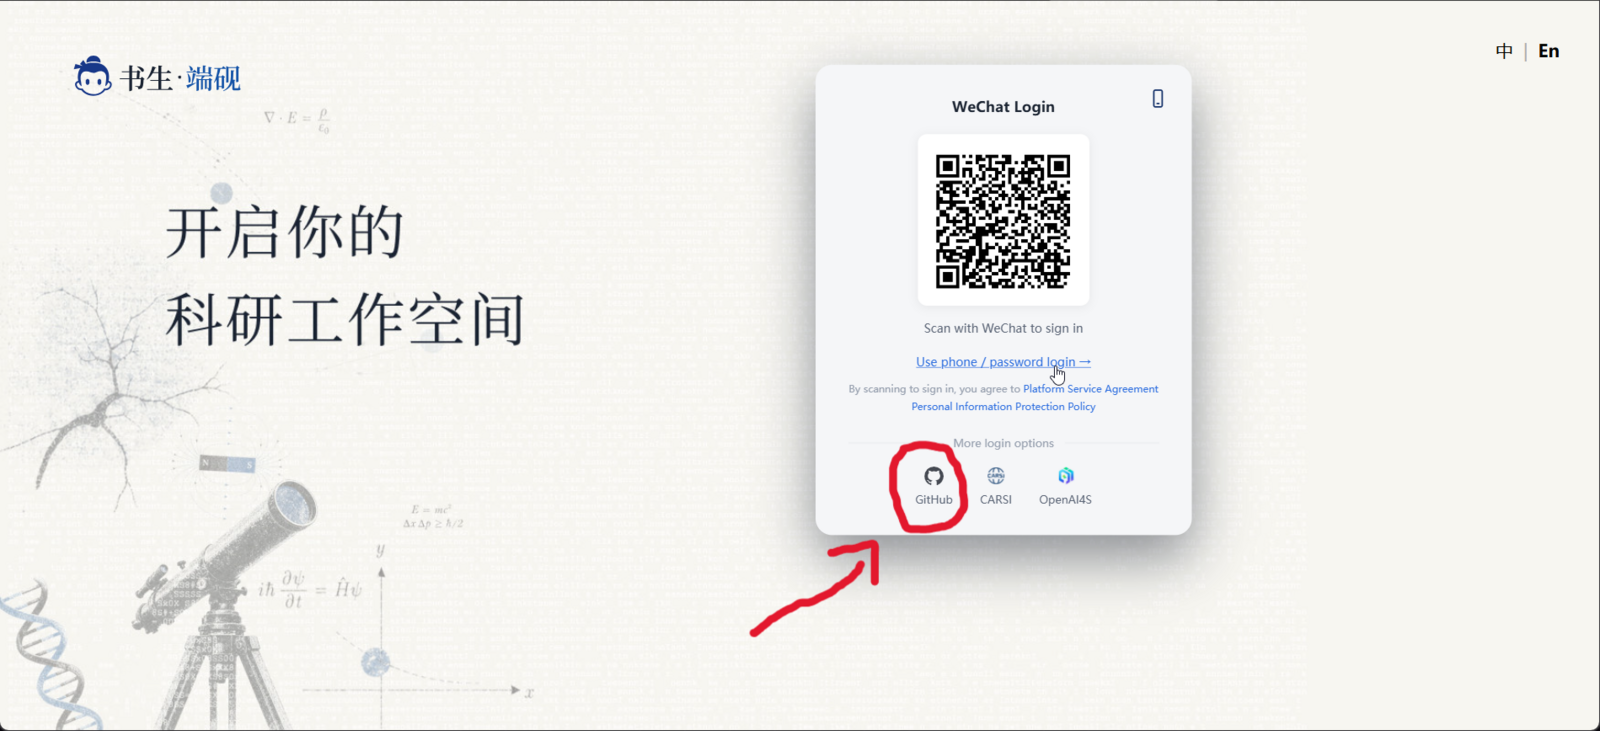
⏱ Tempo real: 39 s.
Gerando a API key
Depois do login, o menu lateral tem a opção Research Models, com a etiqueta Free. É lá que ficam a URL da API, os limites da conta e as chaves.
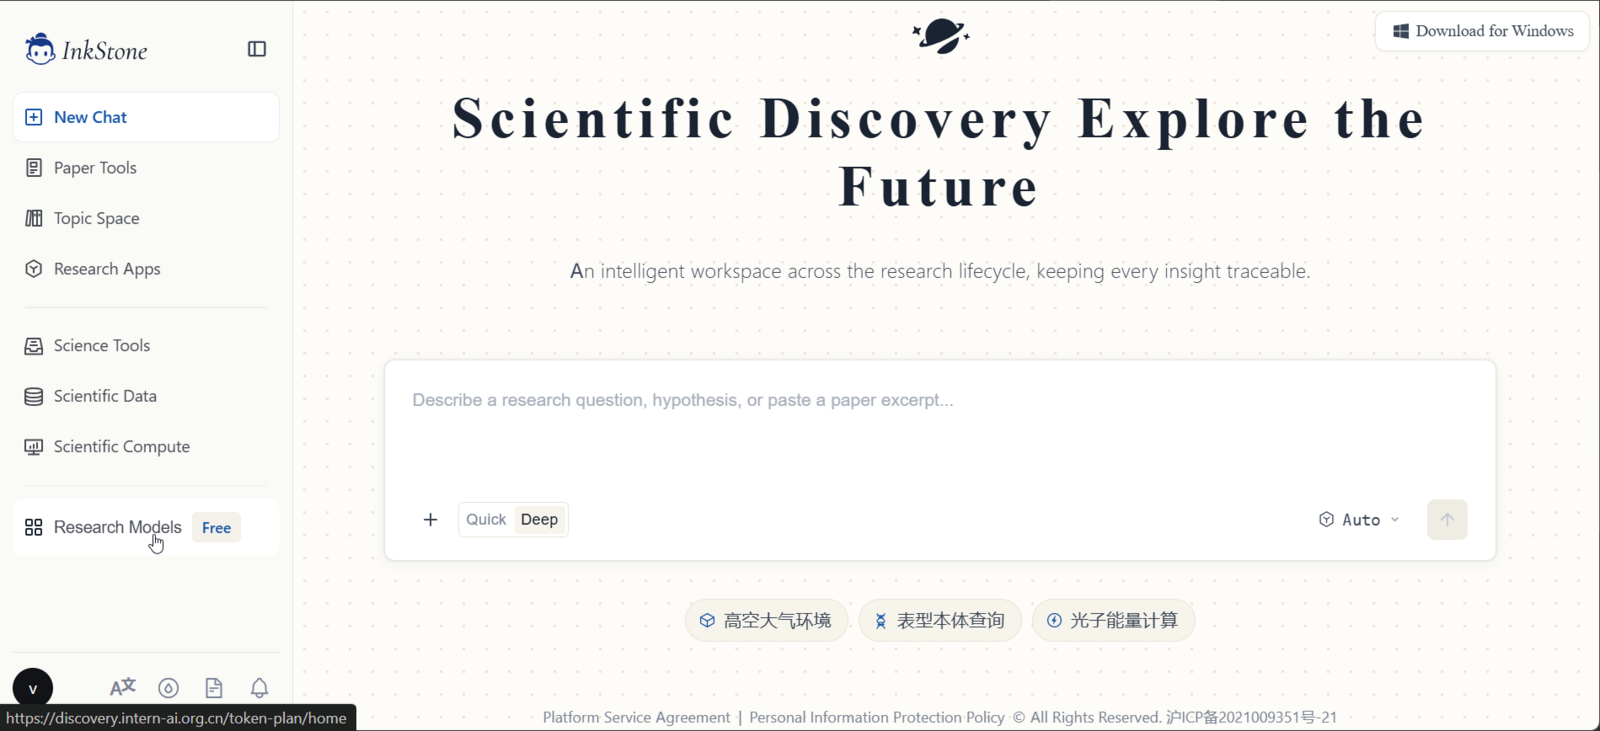
Os limites da conta gratuita, no momento em que escrevi:
- 50 requisições por minuto para modelos de geração e 200 para modelos de decisão;
- 2 milhões de tokens por minuto;
- Créditos com janela de 5 horas (10) e janela semanal (50). Segundo a própria plataforma, 1 crédito cobre até 50 milhões de tokens, usando o DeepSeek V4 Flash como exemplo.
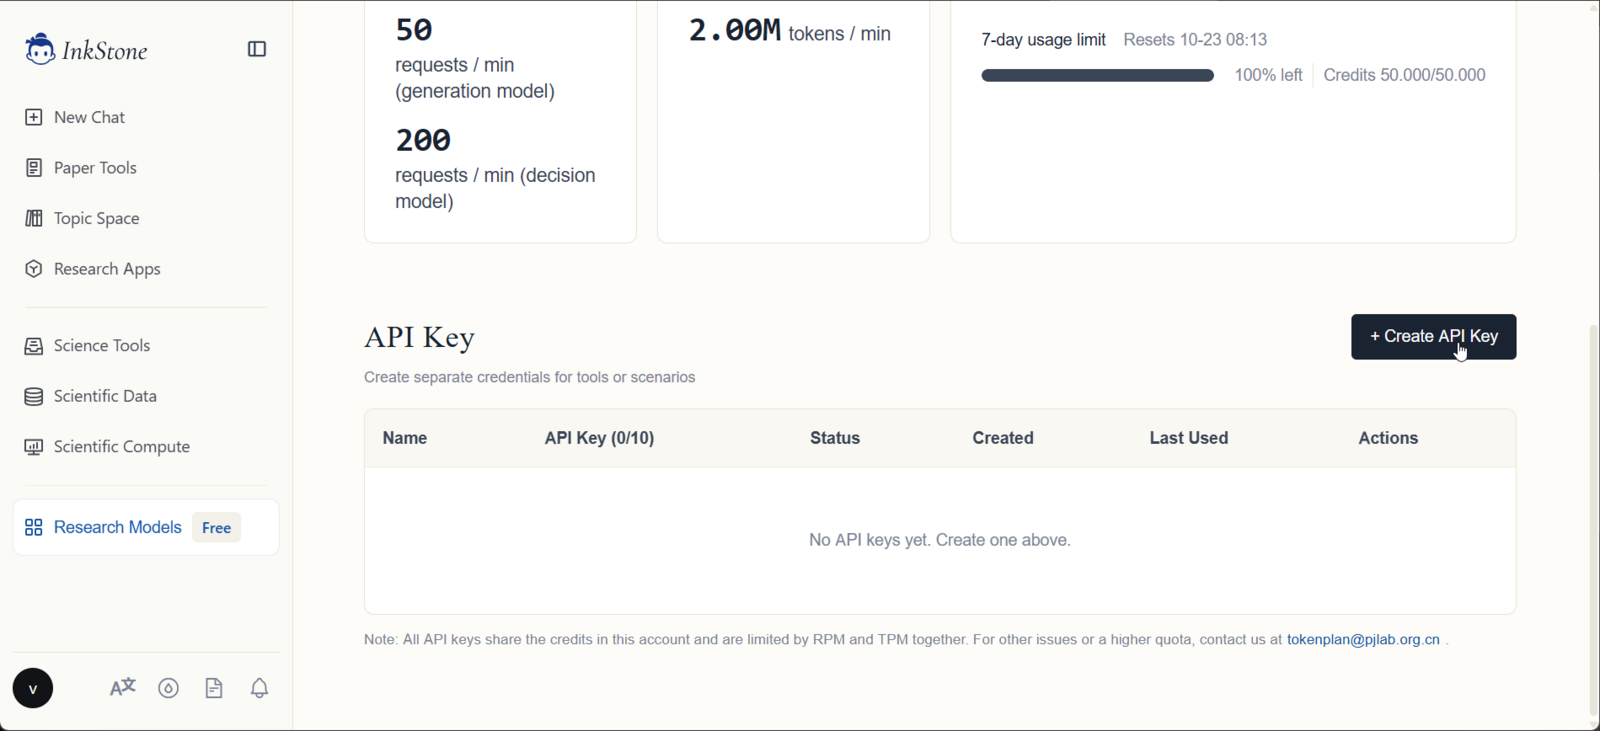
Clique em Create API Key, dê um nome e copie a chave na hora: ela só aparece inteira nesse diálogo. Depois de fechar, a lista mostra apenas o valor mascarado.
⏱ Tempo real: 24 s (vídeo acelerado). A chave aparece desfocada no vídeo.
Parte 2 — Uma WSL só para o projeto
No PowerShell do Windows, criamos uma WSL nova, com nome próprio. Se a opção --name não for reconhecida, rode wsl --update antes. A documentação oficial está em learn.microsoft.com/windows/wsl/install.
wsl --install -d Ubuntu-24.04 --name sdd-lab
Ele pede um usuário e uma senha para o Linux e já entra na WSL. Lá dentro, vamos para o home e criamos a pasta de trabalho:
cd
mkdir workspace
cd workspace/
⏱ Tempo real: 1 min 22 s (vídeo acelerado).
E atualizamos o Ubuntu:
sudo apt update
sudo apt upgrade
⏱ Tempo real: 1 min 17 s (vídeo acelerado).
Parte 3 — Node.js, opencode e OpenSpec
Node.js com nvm
Instalamos o Node.js dentro da WSL, pelo nvm. Isso importa: a WSL enxerga o PATH do Windows, e é fácil acabar usando o Node (ou o opencode) do Windows sem perceber. Mais sobre isso na seção de problemas comuns.
curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.40.1/install.sh | bash
source ~/.bashrc
nvm install --lts
node -v && npm -v
Aqui saiu o Node.js v24.22.0 com npm 11.19.1. Confira a versão mais recente do script no repositório do nvm.
⏱ Tempo real: 44 s (vídeo acelerado).
opencode e OpenSpec
curl -fsSL https://opencode.ai/install | bash
source ~/.bashrc
opencode --version
npm install -g @fission-ai/openspec@latest
openspec --version
O instalador do opencode coloca o binário no PATH pelo ~/.bashrc. O OpenSpec vem pelo npm. Na gravação, saíram o opencode 1.19.1 (atualizamos para a 2.0 mais adiante) e o OpenSpec 1.14.2.
⏱ Tempo real: 1 min 05 s (vídeo acelerado).
Parte 4 — A chave e a configuração
Guardando a API key com segurança
A chave fica num arquivo dentro de ~/.secrets, com permissão só para o seu usuário, e é exportada como variável de ambiente pelo ~/.bashrc:
mkdir -p ~/.secrets && chmod 700 ~/.secrets
nano ~/.secrets/intern_apikey        # cole a chave, Ctrl+O para salvar, Ctrl+X para sair
chmod 600 ~/.secrets/intern_apikey
echo 'export INKSTONE_API_KEY=$(tr -d "[:space:]" < ~/.secrets/intern_apikey)' >> ~/.bashrc
source ~/.bashrc
ls -l ~/.secrets/intern_apikey
echo ${#INKSTONE_API_KEY}
O último comando mostra só o tamanho da chave, nunca o valor. É um jeito simples de conferir que a variável foi carregada sem expor o segredo na tela. O tr remove espaços e a quebra de linha final, que costumam vir junto quando se cola a chave.
⏱ Tempo real: 56 s.
Testando a API
Antes de envolver o opencode, uma chamada direta com curl confirma que chave, URL e modelo estão certos:
curl -s https://discovery-api.intern-ai.org.cn/v1/chat/completions \
  -H "Authorization: Bearer $INKSTONE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-v4-pro-0813","messages":[{"role":"user","content":"Responda em uma frase: o que é spec-driven development?"}]}'
A resposta veio com o texto do modelo e o uso de tokens (17 de entrada, 224 de saída, sendo 160 de raciocínio).
⏱ Tempo real: 14 s (vídeo acelerado).
Configurando o opencode
O opencode aceita qualquer provedor compatível com a API da OpenAI, usando o pacote @ai-sdk/openai-compatible. A configuração fica em ~/.config/opencode/opencode.json (veja a seção Custom provider da documentação):
mkdir -p ~/.config/opencode
cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "model": "intern/deepseek-v4-pro-0813",
  "small_model": "intern/deepseek-v4-flash-0731",
  "provider": {
    "intern": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Intern Discovery",
      "options": {
        "baseURL": "https://discovery-api.intern-ai.org.cn/v1",
        "apiKey": "{env:INKSTONE_API_KEY}"
      },
      "models": {
        "deepseek-v4-pro-0813": { "name": "DeepSeek V4 Pro" },
        "deepseek-v4-flash-0731": { "name": "DeepSeek V4 Flash" },
        "kimi-k2.6": { "name": "Kimi K2.6" },
        "glm-5.3": { "name": "GLM 5.3" }
      }
    }
  }
}
EOF
cat ~/.config/opencode/opencode.json
Repare no "apiKey": "{env:INKSTONE_API_KEY}": o arquivo não guarda segredo nenhum, só aponta para a variável de ambiente. O small_model é usado pelo opencode em tarefas leves, como gerar títulos de sessão.
⏱ Tempo real: 31 s.
Parte 5 — O projeto
Criando o projeto e inicializando o OpenSpec
mkdir -p ~/workspace/sdd-lab && cd ~/workspace/sdd-lab
git init
openspec init --tools opencode
openspec completion install
exec bash
O openspec init --tools opencode cria a estrutura openspec/ e instala no opencode os comandos do fluxo (/opsx-propose, /opsx-apply, /opsx-archive e outros). O completion install ativa o autocompletar com Tab, e o exec bash recarrega o shell.
⏱ Tempo real: 30 s.
Instalando o schema openspec-casadei
O OpenSpec funciona com schemas, que definem os artefatos e as regras de cada etapa. Eu mantenho um schema próprio, público, o openspec-casadei. Entre outras coisas, ele exige cenários no formato AS A / WHEN / THEN / AND, pelo menos um cenário de falha por requisito, testes e documentação em cada grupo de tarefas, e aprovação explícita para qualquer dependência nova.
cd ~/workspace
git clone https://github.com/vcasadei/openspec-casadei.git
cd openspec-casadei
./tools/install.sh --project ~/workspace/sdd-lab
cd ~/workspace/sdd-lab
openspec schema which casadei
O instalador copia o schema para dentro do projeto e troca schema: spec-driven por schema: casadei no openspec/config.yaml. Se preferir o schema padrão do OpenSpec, pule este passo: o resto do artigo funciona igual.
⏱ Tempo real: 30 s (vídeo acelerado).
Atualizando o opencode para a 2.0
Na primeira vez que abri o opencode dentro do projeto, ele já reconheceu o provedor (“Build · DeepSeek V4 Pro · Intern Discovery”) e ofereceu a atualização para a versão 2.0, que está em anoma.ly/notes/opencode-2-0. Dentro do opencode:
/update
⏱ Tempo real: 26 s (vídeo acelerado).
Escolhendo o modelo
Com o opencode 2.0 aberto, /models lista os modelos gratuitos do próprio opencode e os do provedor Intern Discovery. Eu escolhi o DeepSeek V4 Pro e, na pergunta seguinte, a variante de esforço high.
/models
⏱ Tempo real: 33 s (vídeo acelerado).
Parte 6 — O primeiro spec: wordcount
Propose
Este é o pedido que eu enviei, exatamente como digitei:
/opsx-propose Criar uma CLI em Node.js chamado wordcount que recebe o caminho de um arquivo de texto e mostra quantas linhas, palavras, caracteres ele tem. Sem dependências externas. Arquivo inexistente deve gerar uma mensagem clara e código de saída 1. Incluir testes com node:test e coverage de 90%+O comportamento foi exatamente o que o fluxo do OpenSpec pede: antes de escrever qualquer artefato, o modelo leu o schema e as instruções do OpenSpec e fez perguntas sobre o que estava ambíguo no meu pedido.
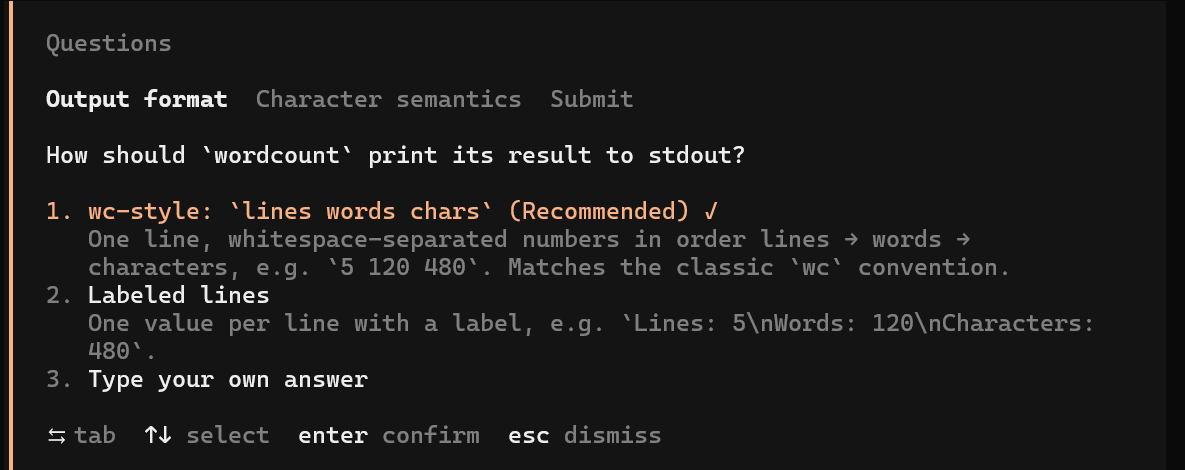
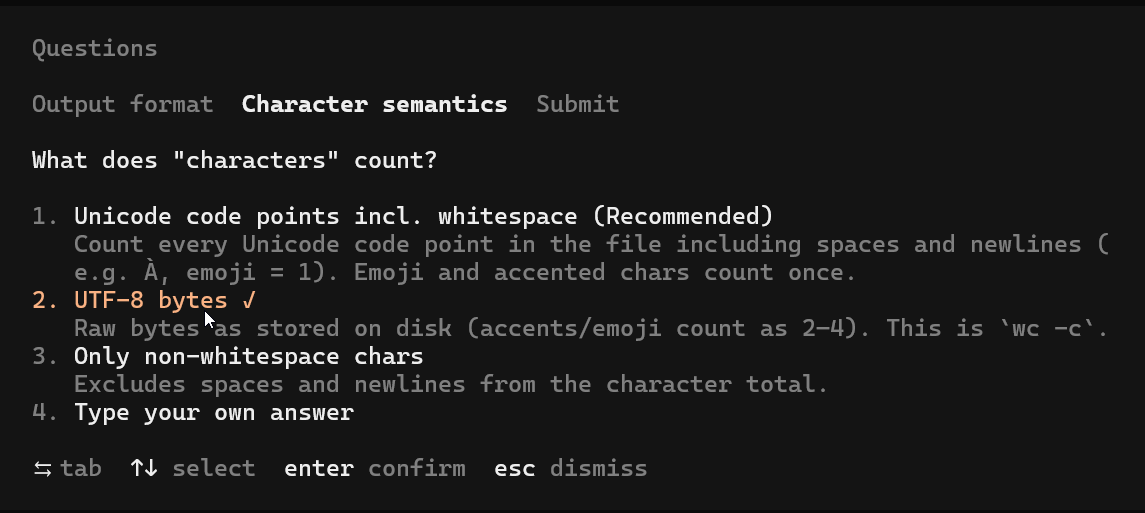
As duas perguntas valem a discussão:
- Formato da saída: escolhi o estilo do
wc(linhas palavras caracteresnuma linha só), que era a opção recomendada. É a convenção que todo mundo conhece e fica fácil de usar em scripts. - O que conta como “caractere”: aqui eu fugi da recomendação. O modelo sugeria contar pontos de código Unicode (acento ou emoji = 1), e eu escolhi bytes UTF-8, que é o que o
wc -cfaz. Assim o resultado é fácil de conferir contra uma ferramenta clássica. “Caractere” parecia óbvio no pedido e não era: em português, “ação” tem 4 caracteres Unicode, mas 7 bytes contando a quebra de linha.
Com as respostas, ele escreveu os quatro artefatos em openspec/changes/add-wordcount-cli/ e validou tudo com openspec validate --strict:
proposal.md: o porquê e o quê. CLI sem dependências, saídalinhas palavras bytes, erro com código 1, cobertura mínima de 90%.specs/wordcount/spec.md: 2 requisitos e 7 cenários. Caminho feliz, arquivo vazio, bytes não ASCII, quebra de linha, argumento ausente, arquivo inexistente e diretório.design.md: leitura do arquivo comoBuffer, uma função puracount(buf)e um CLI fino por cima, CommonJS sem etapa de build e testes comnode:test.tasks.md: 8 tarefas em 3 grupos (lógica de contagem, CLI e portões de qualidade), cada uma com um comando de verificação.
⏱ Tempo real: 11 min 21 s (vídeo acelerado). O opencode mediu 10 min 13 s do envio do pedido ao resumo final.
Esse é o momento de revisar com calma, antes do apply. Nada foi implementado ainda: se algo estiver errado, corrigir agora custa um parágrafo, não um refactor.
Apply
/opsx-apply
O agente leu os artefatos, conferiu o ambiente (Node.js, git, as opções de cobertura nativas do node --test) e implementou tarefa por tarefa: package.json, lib/wordcount.js, bin/wordcount.js, os testes e um README.
O momento mais interessante veio no final. A primeira rodada de npm run test:coverage falhou: a cobertura de branches ficou em 87,5%, abaixo dos 90% que eu pedi, porque o caminho de sucesso do CLI não tinha teste automático. O agente não baixou o limite. Ele escreveu o teste que faltava, rodou de novo, chegou a 100% e ainda registrou no resumo que tinha feito algo além do texto das tarefas. É exatamente o comportamento que a gente quer: a regra veio da spec, não da boa vontade do modelo.
⏱ Tempo real: 6 min 17 s (vídeo acelerado).
O apply em números:
| Tempo (medido pelo opencode) | 6 min 12 s |
| Tarefas | 8 de 8 concluídas |
| Arquivos criados | 6 (package.json, lib/, bin/, 2 arquivos de teste, README.md) |
| Testes | 8 (4 unitários e 4 do CLI), todos passando |
| Cobertura | 100% de linhas, branches e funções |
| Dependências | nenhuma |
| Contexto ao final | cerca de 85 mil tokens (43% da janela) |
Conferindo o resultado
Fora do opencode, no terminal:
cd ~/workspace/sdd-lab
echo -e "uma linha\nduas linhas aqui" > exemplo.txt
node bin/wordcount.js exemplo.txt
node bin/wordcount.js nao-existe.txt
node --test
npm run test:coverage
O exemplo devolveu 2 5 27, o arquivo inexistente gerou wordcount: file not found: nao-existe.txt com código de saída 1, e os 8 testes passaram com 100% de cobertura.
⏱ Tempo real: 1 min 01 s (vídeo acelerado).
Quer conferir a decisão dos bytes? Rode printf "ação\n" > acentos.txt, depois node bin/wordcount.js acentos.txt e wc acentos.txt. Os dois devem mostrar 1 1 7.
Archive
/opsx-archive
O archive faz duas coisas: sincroniza a spec da change com as specs principais do projeto (em openspec/specs/) e move a change para openspec/changes/archive/, como histórico. Como era a primeira capability do projeto, o agente perguntou se devia sincronizar antes de arquivar. Escolhi Sync now: sem isso, a spec do wordcount ficaria só no histórico, e a próxima change não teria onde se apoiar. Ele criou openspec/specs/wordcount/spec.md, validou com openspec validate --specs --strict e moveu a change para openspec/changes/archive/2026-10-15-add-wordcount-cli/.
⏱ Tempo real: 5 min 20 s (vídeo acelerado).
Para conferir pelo terminal: openspec list --specs.
Quanto custou
No fim do exercício inteiro, do cadastro ao archive, a conta ainda tinha 70% do limite de 5 horas e 94% do limite semanal.
Problemas comuns
| Sintoma | Causa e solução |
|---|---|
O cadastro não avança; o console mostra 405 |
O firewall do site bloqueia o cadastro por e-mail. Entre com o GitHub (uma conta descartável). |
O opencode diz invalid api key com a chave configurada |
Quase sempre é o opencode do Windows rodando dentro da WSL. Programas do Windows não enxergam as variáveis de ambiente da WSL. Confira com which opencode node npm openspec: todos os caminhos devem começar com /home/.... Se algum começar com /mnt/c/..., desinstale a versão do Windows. |
echo ${#INKSTONE_API_KEY} mostra 0 |
O shell não recarregou. Rode source ~/.bashrc ou abra um terminal novo. |
| O propose ou o apply fica minutos sem mudar a tela | Provavelmente não travou: é o plano gratuito. Espere. Para tarefas leves, o DeepSeek V4 Flash é mais rápido. |
A documentação do opencode tem uma página específica sobre o uso no Windows e na WSL: opencode.ai/docs/windows-wsl.
Limitações honestas
- Velocidade. Já falei, mas vale repetir: um ciclo que leva poucos minutos com modelos pagos mais rápidos levou mais de 20 aqui. Para estudar, é ótimo. Para trabalhar, pesa.
- Cota e limites. 50 requisições por minuto e créditos por janela de tempo bastam para estudar, mas uma sessão longa de apply pode bater no limite.
- Dados. É um serviço gratuito, hospedado fora do Brasil, sob outras leis. Nada de dados pessoais de terceiros, código da empresa ou segredos.
- Disponibilidade. Serviços gratuitos mudam de regra, de cota ou saem do ar. A boa notícia é que o opencode aceita qualquer provedor compatível com a API da OpenAI: se o Intern Discovery mudar, você troca a URL e a chave no
opencode.jsone o resto do ambiente continua igual. - Modelos variam. O DeepSeek V4 Pro seguiu muito bem as instruções do OpenSpec e do schema. Vale testar o GLM 5.3 e o Kimi K2.6 nas mesmas tarefas (é só trocar com
/models) e comparar.
O que fica
O ponto principal deste exercício, para mim, é que o método não depende da ferramenta. O que dá previsibilidade é o combinado escrito antes do código: a proposta revisada, os cenários de falha, as tarefas com verificação, a spec que vira documentação oficial. Com um agente e um modelo completamente diferentes, o comportamento foi o mesmo: o modelo perguntou antes de escrever, implementou seguindo as tarefas, foi barrado por um portão de qualidade que veio da spec e corrigiu o código em vez de afrouxar a regra.
Se você não tinha como praticar SDD por falta de acesso a uma ferramenta paga, agora tem. Monte o seu sdd-lab, rode o wordcount e depois tente com um projeto seu.
Referências e links úteis
- Spec-Driven Development
- OpenSpec · Documentação
- openspec-casadei, o meu schema público para o OpenSpec
- Spec-driven development with AI: Get started with a new open source toolkit, artigo do GitHub sobre o Spec Kit
- opencode
- Modelos e API
- Ambiente
Se este guia te ajudou a montar o seu ambiente ou destravou o seu estudo de SDD, me conta no LinkedIn (linkedin.com/in/vcasadei) ou confira outros projetos e textos que publico em vcasadei.com.